治理与可观察性Governance & Observability
让人类随着时间的推移信任代理的模式。
本书中有 46 种模式。 · 已更新
何时使用每种模式
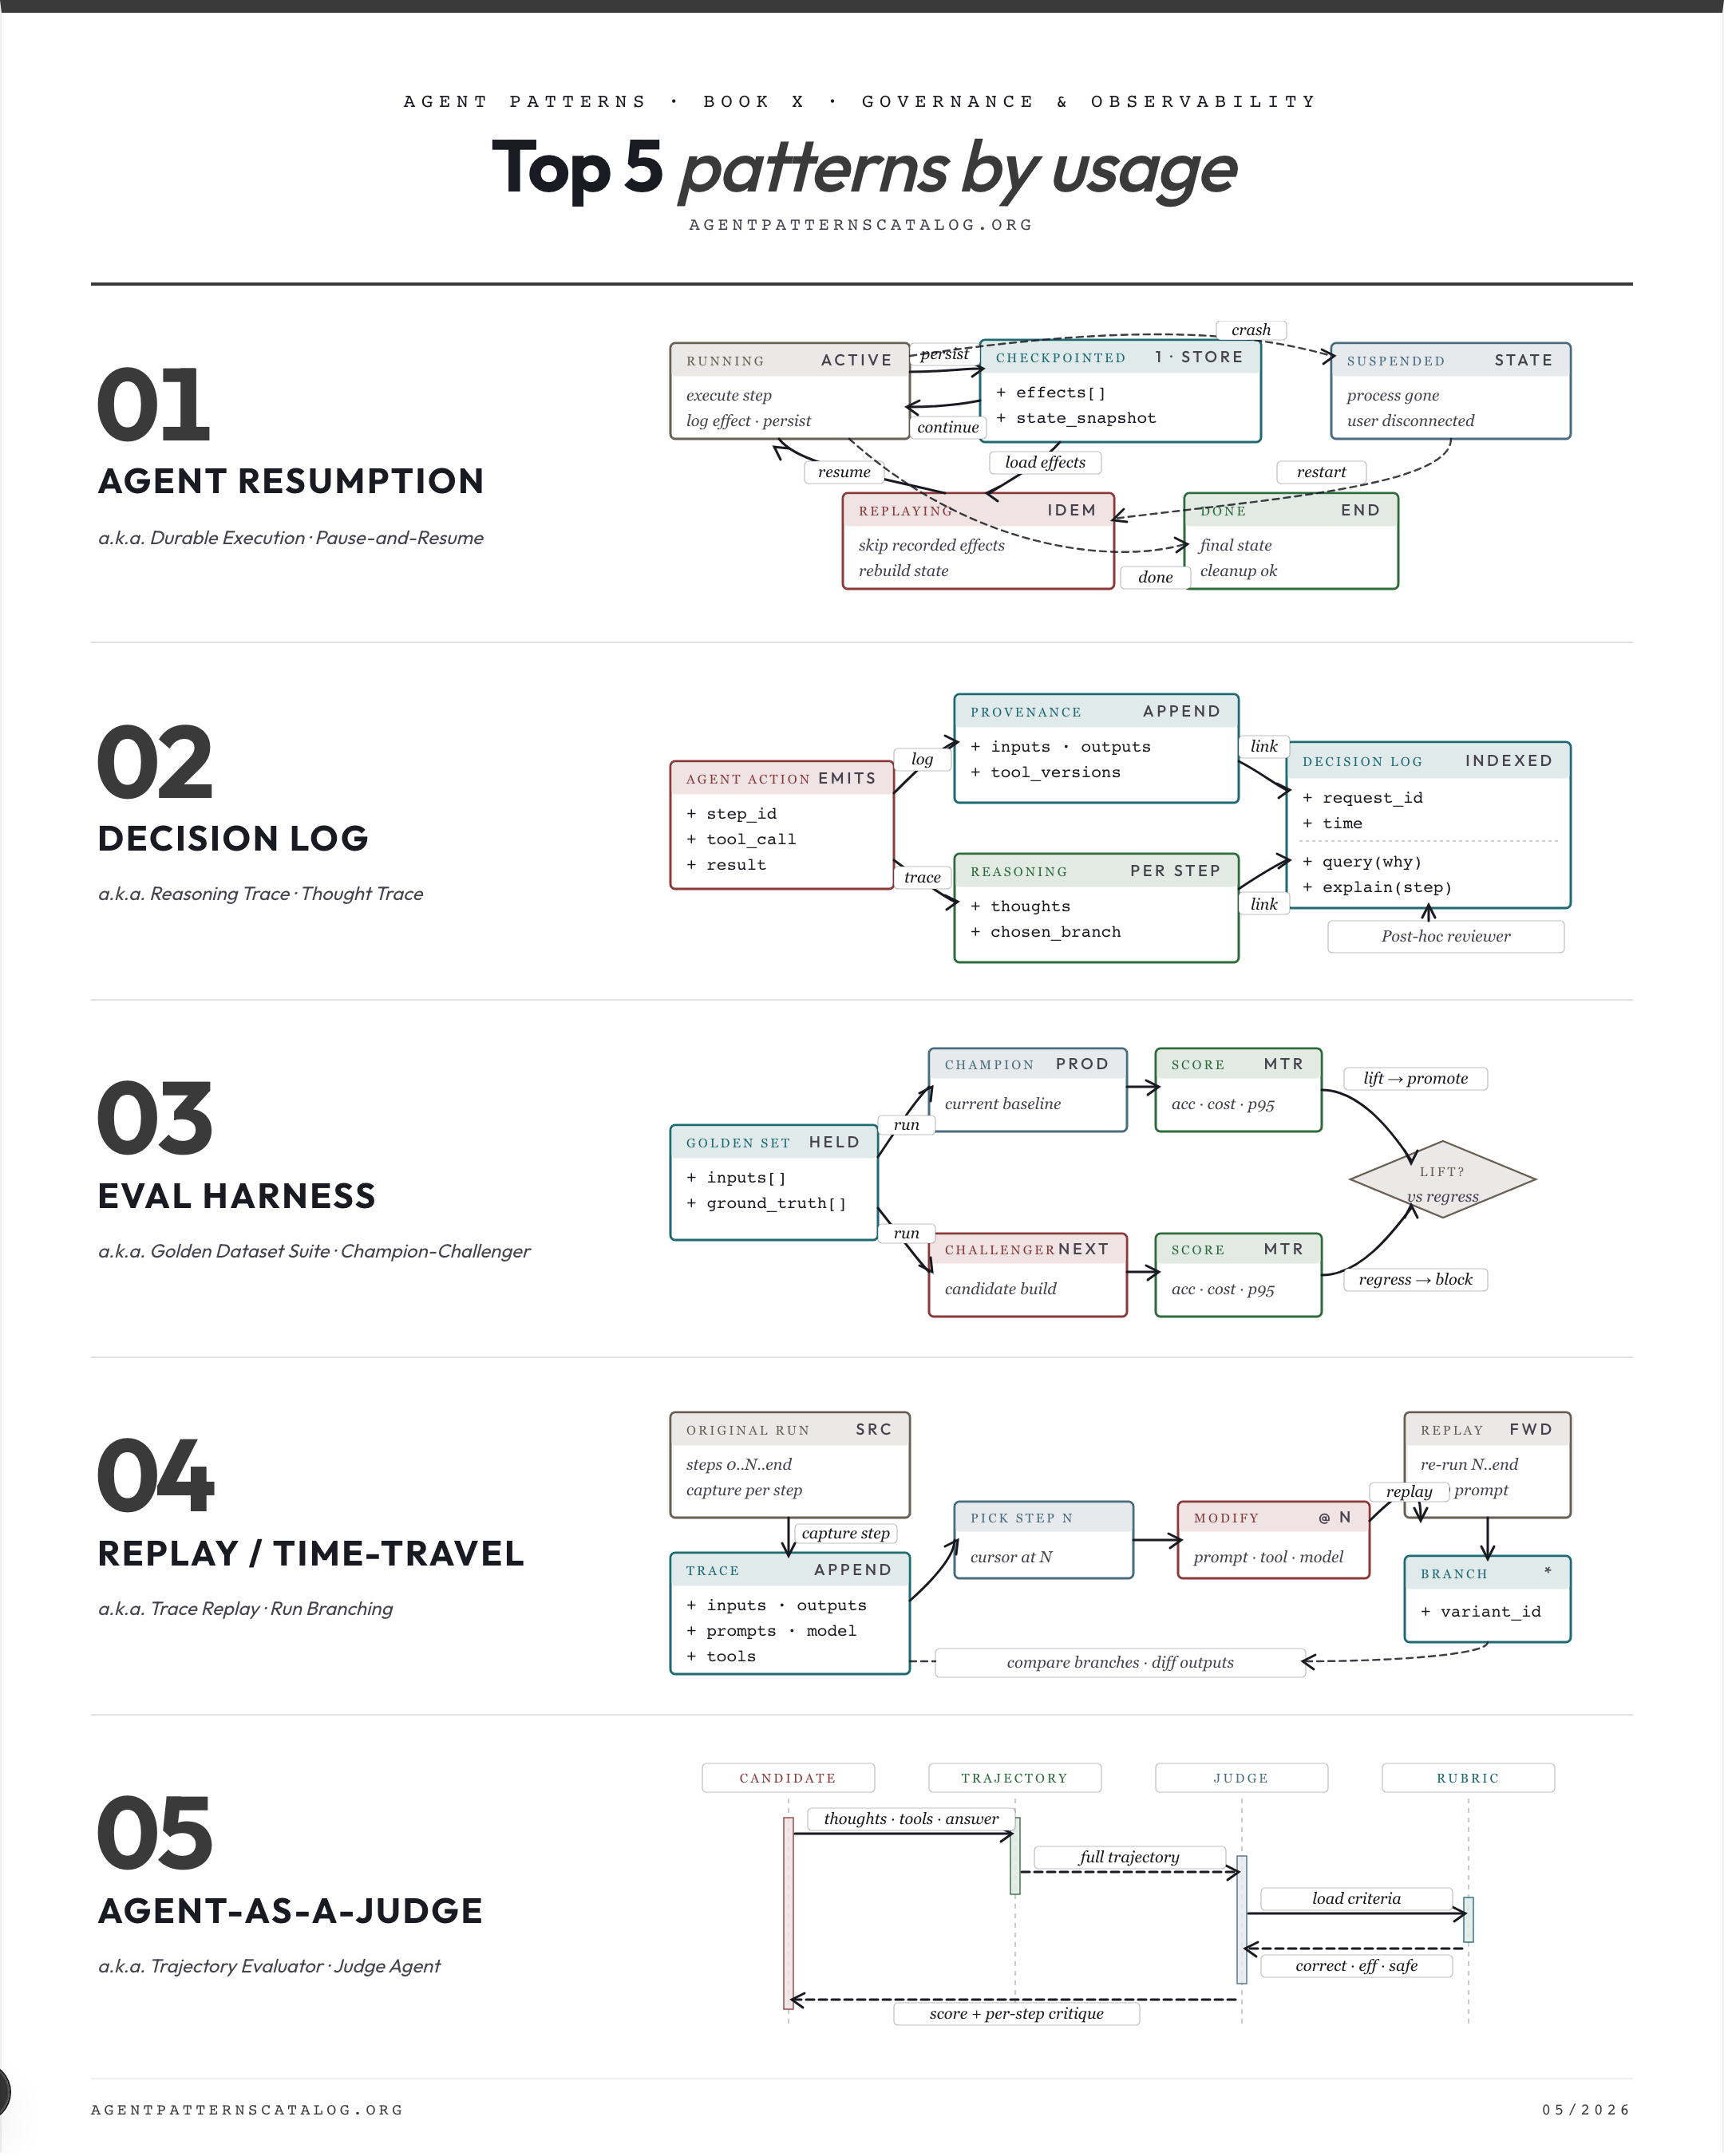
01. Agent Resumption 持久化代理执行状态,以便长时间运行的任务能够在重启、部署或用户断开连接后继续进行。 最佳适用: 代理运行时间足够长,以至于重启、部署或断开连接会丢失有意义的工作。 权衡: 检查点存储成本。 注意事项: 运行在几秒钟内完成,可以简单地从头开始重试。
02. Eval Harness 运行一个保留的数据集以检测代理版本的回归并衡量改进。 最佳适用: 一种“感觉更好”的变化可能在您的系统中默默地退化质量。 权衡: 数据集偏见意味着高分可能掩盖现实世界的失败。 注意事项: 不存在预期输出(开放式创意任务),评分将是主观的。
03. Decision Log 在代理的行动旁边持久化其推理轨迹,以便事后审查可以解释原因。 最佳适用: 仅操作日志使您无法解释代理为什么这样做。 权衡: 存储和隐私影响。 注意事项: 推理日志将被保留而没有任何审查过程来咨询它们。
04. LLM-as-Judge 使用LLM根据评分标准对开放式输出进行评分,当没有精确匹配指标适用时。 最佳适用: 需要在没有参考答案的情况下进行开放式输出的自动回归检测。 权衡: 评审者的偏见以微妙的方式扭曲分数。 注意事项: 已经有精确匹配或参考指标对任务进行评分。
05. Replay / Time-Travel 从任何步骤重新运行过去的代理轨迹,使用修改过的输入/提示/工具进行调试或分支。 最佳适用: 代理运行是非确定性的,事件需要可重现的调试。 权衡: 跟踪存储开销。 注意事项: 跟踪存储成本超过重放的价值(低风险的短暂运行)。
本书中的所有模式
Agent Resumption
×38持久化代理执行状态,以便长时间运行的任务能够在重启、部署或用户断开连接后继续进行。
Eval Harness
×17运行一个保留的数据集以检测代理版本的回归并衡量改进。
Decision Log
×14在代理的行动旁边持久化其推理轨迹,以便事后审查可以解释原因。
LLM-as-Judge
×10使用LLM根据评分标准对开放式输出进行评分,当没有精确匹配指标适用时。
Replay / Time-Travel
×7从任何步骤重新运行过去的代理轨迹,使用修改过的输入/提示/工具进行调试或分支。
Provenance Ledger
×6记录每个代理的决策和状态变化,并附上足够的元数据以便后续解释或逆转。
Agent-as-a-Judge
×6通过另一个代理评估代理的完整轨迹(步骤、工具调用、中间状态),而不仅仅是评分最终输出。
Lineage Tracking
×5追踪每个代理输出是由哪个提示版本、模型版本和数据源产生的。
Eval as Contract
×4将评估套件视为代理必须满足的合同;仅在评估通过时发布版本。
Shadow Canary
×4在冠军旁边以影子方式运行候选代理版本,比较输出而不影响用户。
Dual Evaluation (Offline + Online)
×4运行两个平行的评估轨道——在部署前进行离线基准测试,并在部署后进行在线生产流量监控——以便即使在预部署基准通过时也能捕捉到漂移。
Cost Observability
×3实时向操作员展示每个请求、每个用户和每个功能的成本和令牌消耗。
Prompt Versioning
×3将提示视为不可变的、哈希的、带有语义版本控制的工件,存储在注册表中;像代码一样部署和回滚。
Agent Middleware Chain
×3将每个模型调用、工具调用和内存访问包装在一个可组合的预处理/执行/后处理拦截器管道中,以便跨切关注点可以附加而不触及代理或调度器代码。
Durable Workflow Snapshot
×3将工作流执行状态作为快照捕获到可插拔的存储提供者中,以便在不同部署、进程重启和主机崩溃之间恢复暂停的运行。
Re-Contact-Subtracted Resolution Gate
×3基于重新联系减法分辨率率对支持代理进行限制,以确保仅结束会话的交互不会被报告为已解决。
Sandbox Escape Monitoring
×3将沙盒边界违规视为遥测;对超出预期范围的系统调用、网络出口或文件系统写入发出警报。
Simulated-User Rollout Evaluation
×3通过将对话代理与一个扮演用户的第二模型配对来评估对话代理,该模型具有特定的人物角色和隐藏目标,然后对最终环境状态进行评分,而不是对话记录。
Journaled LLM Call
×2在第一次执行时记录每个非确定性步骤的输出,并在崩溃恢复期间重放该记录的值,而不是重新调用模型。
Production Failure Triage Loop
×2将每个生产代理故障分类为一个小的固定分类法,并将每个类别绑定到一组修复路径,以便修复能够机械地调度,并且监控到修复的循环保持足够快速,以便控制扩展。
Sampled Prompt Trace Eval
×2从生产环境中捕获完整的提示/响应/元数据跟踪到监控数据集中,但仅对随机样本进行LLM-judge评估,以便在流量增长时监控成本保持在可控范围内。
Scorer Live Monitoring
×2在生产环境中异步评分代理输出,使用非阻塞评分器进行观察、警报和记录,但不重新生成输出。
Agent Evaluator
×1一个专门的代理或工具,其唯一工作是对另一个代理的输出进行测试以评估性能;与 eval-harness(离线批处理)和 llm-as-judge(逐输出)不同。
Agent Factory
×1从一个版本化模板中制造代理实例,该模板原子性地呈现模型、工具和提示,并具有基于注册表的身份,以便整个代理群保持一致,并且一个模板的更改能够传播,而不是每个实例漂移。
Agent Liability Insurance
×1通过特定于代理的保险覆盖将自主代理失败的剩余风险转移给保险公司,采用可审计的认证标准作为保险资格的门槛,从而使无限责任变为有限的、可定价的成本。
Bayesian Bandit Experimentation
×1用一个动态重新分配流量到表现更好的变体的赌博者替代代理变体之间的固定分割A/B测试,这基于观察到的奖励,限制来自糟糕变体的遗憾。
Chance-Corrected Judge Validation
×1在一个保留的元评估集上,使用机会校正的一致性统计量来衡量自动评审与人工标签的匹配程度,并在评审被允许进行筛选的每个分数旁边发布该数字。
Decision Token
×1在重要行动执行的瞬间铸造一个自包含的记录,捆绑触发的规则、读取的确切数据、得出的结论和授权身份。
Intermediate Artifact Evaluation
×1评估中间工件(计划、工具调用痕迹、护栏反应),而不仅仅是最终输出;将失败隔离到特定的管道节点。
Managed Agent Runtime
×1将代理循环本身作为一个托管的云原语提供,以便调用者提供模型、系统提示和工具,平台在一个隔离的、会话范围的运行时中运行编排。
Own Your Prompts (12-Factor Agents)
×1生产代理中的每个提示都经过版本控制、测试,并由应用程序代码库中的团队拥有——绝不作为框架默认值继承。
Scaffold Ablation on Model Upgrade
×1在每次模型升级时,将每个支架组件视为对模型弱点的编码假设,并消除新模型不再需要的组件,受评估的限制。
Served-Policy Anchoring
×1将推理引擎实际服务的策略视为优化和限制的对象,而不是训练引擎计算的策略,并持续测量它们的概率一致性。
Deontic Token Delegation
×1将义务、权限和禁止事项具体化为可转移的义务令牌,代理在委托链中传递这些令牌,并附带来源信息,从而使责任和问责与工作一起转移,而不仅仅是执行工作的凭证。
Multi-Principal Welfare Aggregation
×1当一个代理服务于多个具有冲突偏好的用户时,明确声明聚合规则,而不是让其在提示或微调中隐含。
Agent Withdrawal Criteria
在生产之前就量化阈值达成一致——成本与人类基线、纠正率、安全事件——其违反将触发文档化的撤回提案,使得弃用成为一个设计决策,而不是失败。
Agentic Golden Path
限制代理在平台策划的黄金路径上,遵循可读的标准,并在工作过程中检查漂移,以确保其输出在构建时合规,而不是后期修正。
As-Of Information-Set Pinning
将每个输入绑定到其按时间戳存在的信息集,包括模型快照、检索语料库、参考数据和表版本,并记录该固定。
Compliance-Certified Launch Gate
要求外部监管机构在生成服务可以向公众提供之前,依据已发布的内容安全标准对其进行认证,从而将标准的控制措施强制纳入构建中,作为可再认证的工件。
Harness-Native Rollout Capture
通过拦截代理已经运行的工具中的模型调用边界,捕获强化学习的回合,记录确切的提示和响应令牌 ID,而不是从转录中重建它们。
Postmortem Pattern Mining
通过一个分阶段模型管道挖掘成千上万的书面事后分析,进行总结、分类、分析和聚合,以便重复发生的事件原因以一份简短报告的形式浮现出来。
Rigor Relocation
将验证的严格性从模型循环转移到周围的支架(评估、判断、决策日志、策略门),以便在包装器捕获失败,而不是代理。
Serving-Stack Attestation
将服务的模型、推理后端和生成默认值视为未经验证的声明,并通过与每个结果一起记录的黑箱行为探测器来建立它们。
Silent Pilot-to-Production Promotion
反模式:让一个表现良好的试点在不知不觉中扩大范围,直到它成为一个事实上的生产决策系统,同时保持“试点”标签,以便它永远不会触发上线治理门槛。
Attention-Manipulation Explainability
通过扰动所有变换器层的注意力并测量输出概率的变化,揭示哪些输入标记导致了给定的输出,从而生成每个标记的相关性图,同时提供模型的响应。
Determinism-Tiered Replay Gate
通过重新运行相同的输入将代理分类到可重复性层级,对于受监管的决策要求最严格的决策确定性层级,并根据测量的层级限制部署和验证样本大小。