记忆Memory
代理记住了什么,在哪里,持续多长时间。
本书中有 35 种模式。 · 已更新
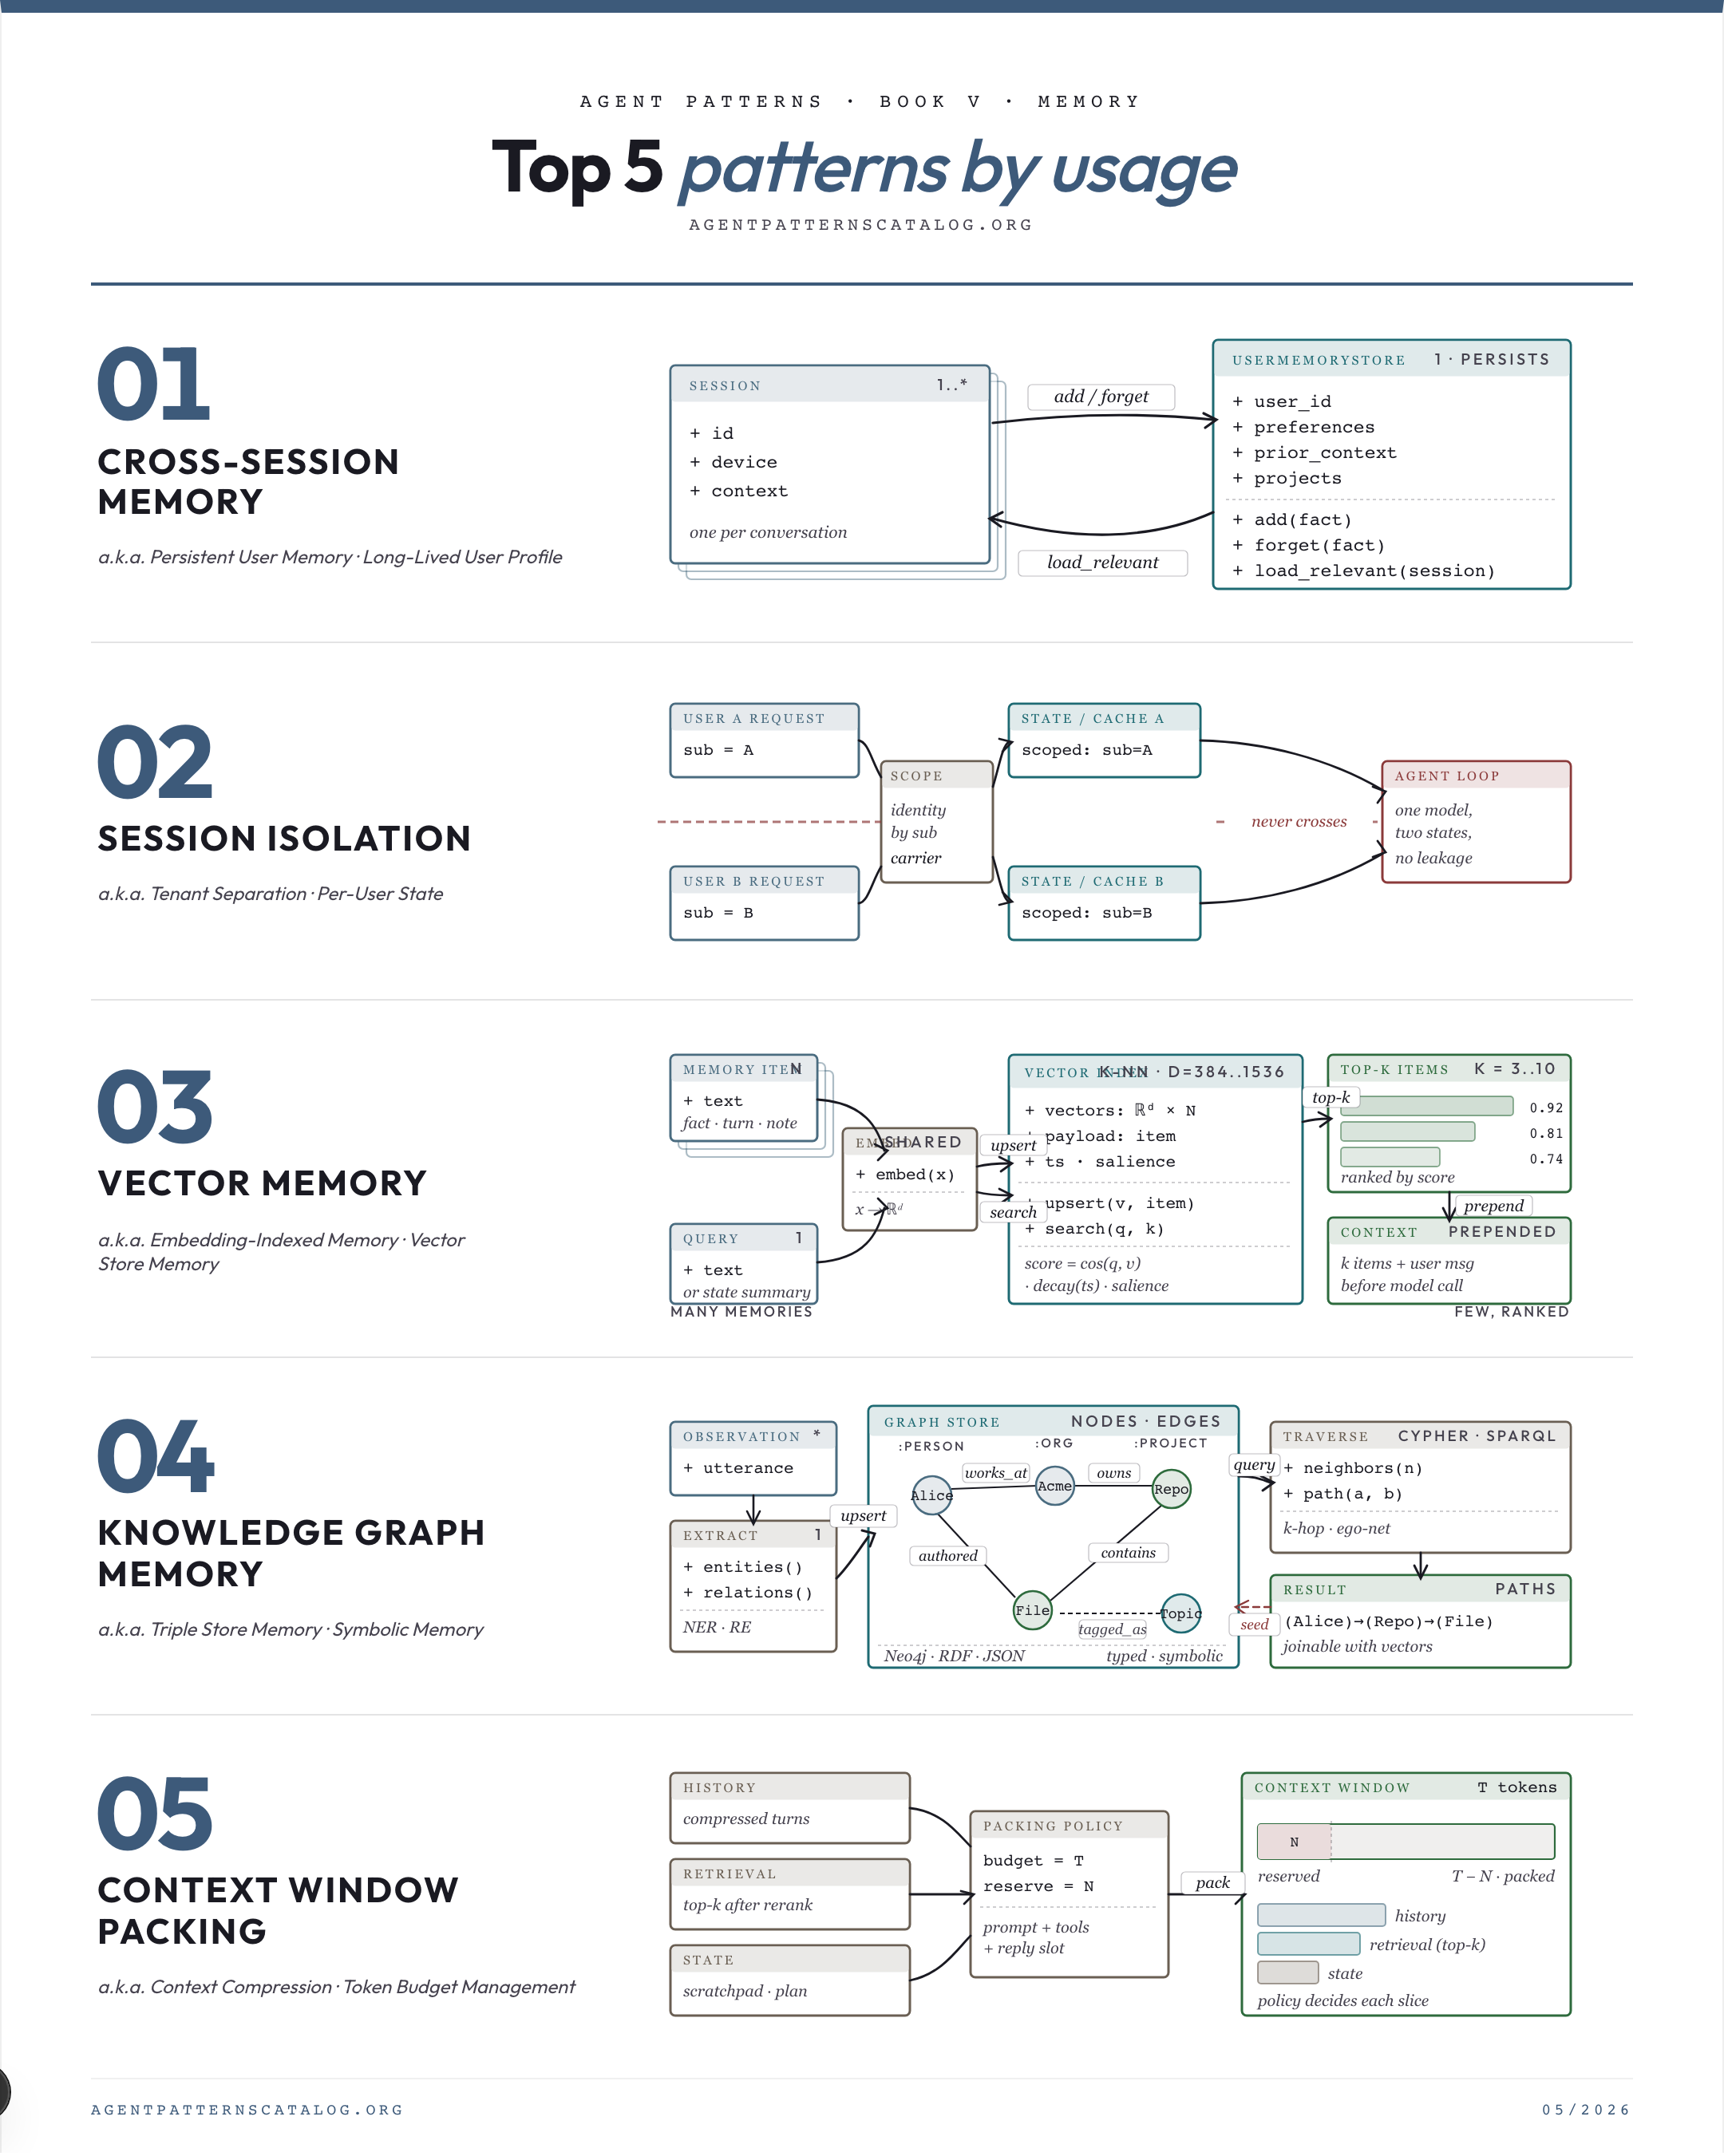
何时使用每种模式
01. Cross-Session Memory 在所有会话、线程和设备之间持久化用户特定的事实、偏好和先前上下文。 最佳适用: 每个线程的记忆在会话之间丢失重要的用户特定事实,助手感觉像是失忆了。 权衡: 隐私义务。 注意事项: 出于隐私或合规原因,会话故意保持无状态。
02. Session Isolation 保持一个用户的会话状态和记忆对另一个用户的代理不可达。 最佳适用: 多个用户共享一个代理后端,且跨用户泄漏是不可接受的。 权衡: 失去跨用户缓存的好处。 注意事项: 代理服务于单个用户或完全信任的租户。
03. Vector Memory 将记忆存储为嵌入向量,并在查询时检索最语义相似的项目。 最佳适用: 长期运行的代理积累的事实,其相关性最好通过相似性来判断。 权衡: 错过纯时间查询('我昨天做了什么?')。 注意事项: 内存较小,类型化的键值存储会更合适。
04. Knowledge Graph Memory 将代理记忆作为实体和关系持久化为结构化图形,以便可以进行符号查询(路径、邻居、类型)。 最佳适用: 代理必须回答关于记忆实体的关系查询(路径、邻居、类型)。 权衡: 提取质量限制图质量。 注意事项: 记忆是非结构化文本,其中向量搜索已足够。
05. Context Window Packing 根据固定的令牌预算选择每次回合中适合放入上下文窗口的内容。 最佳适用: 简单的连接超出了现实输入的上下文窗口。 权衡: 打包逻辑的复杂性。 注意事项: 输入很小,并且总是舒适地适合窗口。
本书中的所有模式
Cross-Session Memory
×23在所有会话、线程和设备之间持久化用户特定的事实、偏好和先前上下文。
Session Isolation
×18保持一个用户的会话状态和记忆对另一个用户的代理不可达。
Vector Memory
×7将记忆存储为嵌入向量,并在查询时检索最语义相似的项目。
Knowledge Graph Memory
×6将代理记忆作为实体和关系持久化为结构化图形,以便可以进行符号查询(路径、邻居、类型)。
Context Window Packing
×5根据固定的令牌预算选择每次回合中适合放入上下文窗口的内容。
Five-Tier Memory Cascade
×5在感官、工作、短期、情节和长期层级中分阶段代理记忆,并在它们之间进行明确的提升和衰减。
MemGPT-Style Paging
×4将LLM上下文窗口视为RAM,将外部存储视为磁盘,模型发出工具调用以进行内存的分页。
Episodic Summaries
×3将过去的情节压缩成摘要,保留要点,同时减少令牌成本。
Short-Term Thread Memory
×3在会话中跨回合携带相关的对话上下文片段。
Append-Only Thought Stream
×3使代理的思维日志仅可追加,以便代理无法重写自己的历史。
Episodic Memory
×2记录过去的事件作为带时间戳的第一人称体验,代理可以在后续回忆,与提取的事实(语义)和学习的操作(程序性)分开。
Filesystem as Context
×2将文件系统用作代理的外部工作记忆,将计划、笔记和大型工具输出写入文件,从实时窗口中删除,并根据需要重新读取。
Reasoning Trace Carry-Forward
×2对于发出单独推理追踪的推理模型,在同一逻辑任务回合(跨工具调用/结果回合)中保持该追踪在上下文中的存在,但在用户回合边界处丢弃它。
Semantic Memory
×2维护一个专门的存储区,记录代理认为关于用户和世界的真实信息,与事件记录(情节性)和学习的操作方法(程序性)分开。
World-Model Graph Memory
×2作为代理的权威世界模型的记忆存储,结构为类型化实体-关系图,用于规划——不仅仅用于检索。
Adaptive Memory Decay
×1给每个长期记忆项一个保留分数,该分数随着时间的推移而衰减,衰减函数受相关性、访问频率和最近性的调节,因此未强化的项会逐渐消失或融合,而被使用的项则会持续存在。
Agentic Memory
×1将记忆管理作为第一类工具操作(添加、更新、删除、检索、摘要、过滤),LLM在每一步选择,进行端到端训练,使短期和长期记忆在一个学习策略下共存。
Context Compaction
×1当上下文窗口接近其限制时,用模型生成的摘要替换较旧的对话片段,该摘要保留决策、承诺和活动约束,同时丢弃噪声,以便代理能够继续运行而不失去线索。
Procedural Memory
×1在情节记忆(过去事件)和语义记忆(事实)之外,维护第三种代理记忆类型:程序记忆捕捉*学习如何做*——可重用的技能、工作流程和自我重写的系统指令,直接将情况映射到行动。
Salience Attention Mechanism
×1使用加权显著性函数对每个候选记忆项进行评分,以便每次迭代关注一个小的、相关的前k个子集,而不是重新阅读所有记忆。
Co-Located Memory Surfacing
×1在用户提到代理之前已知的具体实体时,主动显现相关的持久记忆,以便用户不必承担记住提问的负担。
Hippocampal Rehearsal
×1当某个事物重新关注它们时,将归档的记忆项提升回短期层。
Now-Anchoring
×1将代理的推理基于当前绝对时间,而无需调用工具,因此每个回复都隐含着时间意识。
Self-Corpus Vocabulary
×1从代理的写作中挖掘一个小的有限词汇,并将其缓存为评分新想法的概念轴,以便相关性反映代理的实际框架,而不是通用嵌入空间。
Sleep-Time Compute
×1在空闲或停机期间,离线运行模型以用户的现有上下文进行预计算密集摘要和可能的未来答案,以便在用户实际提问时降低测试时间的延迟和成本。
Information Chunking for Agent Memory
在将输入提供给短期记忆之前,将其结构化为可消化的主题段(块),而不是将完整输入直接抛给模型;减少过载并提高准确性(在客户服务部署中观察到约40%的改善)。
Memory-Type Storage Specialization
使用针对每种内存类型优化的不同存储技术——快速的内存存储(Redis类)用于情节记忆,向量数据库(Pinecone/Weaviate)用于语义记忆,关系型或工作流引擎用于过程记忆——而不是为所有内容使用一个通用存储。
Scratchpad
为代理提供一个可写的草稿空间,用于中间笔记,这些笔记会影响后续的回合,但不会污染响应。
Context Window Dumb-Zone Cap
将上下文窗口的利用率保持在工作阈值以下(约40%),以使模型避免进入'愚蠢区',在该区域模型开始忽略早期指令并产生幻觉。
Execution-State Ledger
维护一个模型外的执行状态,记录运行所观察到的、改变的和尝试的内容,并在每一步之前咨询它,以便拒绝过时的观察并重用仍然有效的结果。
Three Layers of Agentic AI Memory
将代理记忆架构设计为三个集成的同心层 — 短期记忆(外层)、长期记忆(中层)、反馈循环(核心) — 作为一个整体而不是可分离的可选组件一起运作。
Unstructured Human Capture Layer
保持一个人类创作的原始转储层,代理可以读取但绝不能编辑,并将所有结构化内容限制在一个单独的派生层中,以便未形成的思维作为持久的上下文得以保存。
Context Folding
让代理在一个子任务中分支到一个临时子上下文,并在完成时将其折叠回一个简短的总结,以便长时间的任务保持在一个小的活动窗口内。
Landmark Attention
一种长上下文注意机制,在非常长的输入中放置稀疏的地标令牌,使模型通过地标查找直接跳转到相关部分,而不是线性扫描。
Test-Time Memorization (Titans)
在推理时通过将最近的输入纳入其参数来学习的记忆模块,而不是仅依赖于预训练的权重。