规划与控制流程Planning & Control Flow
循环的形状。
本书中有 45 种模式。 · 已更新
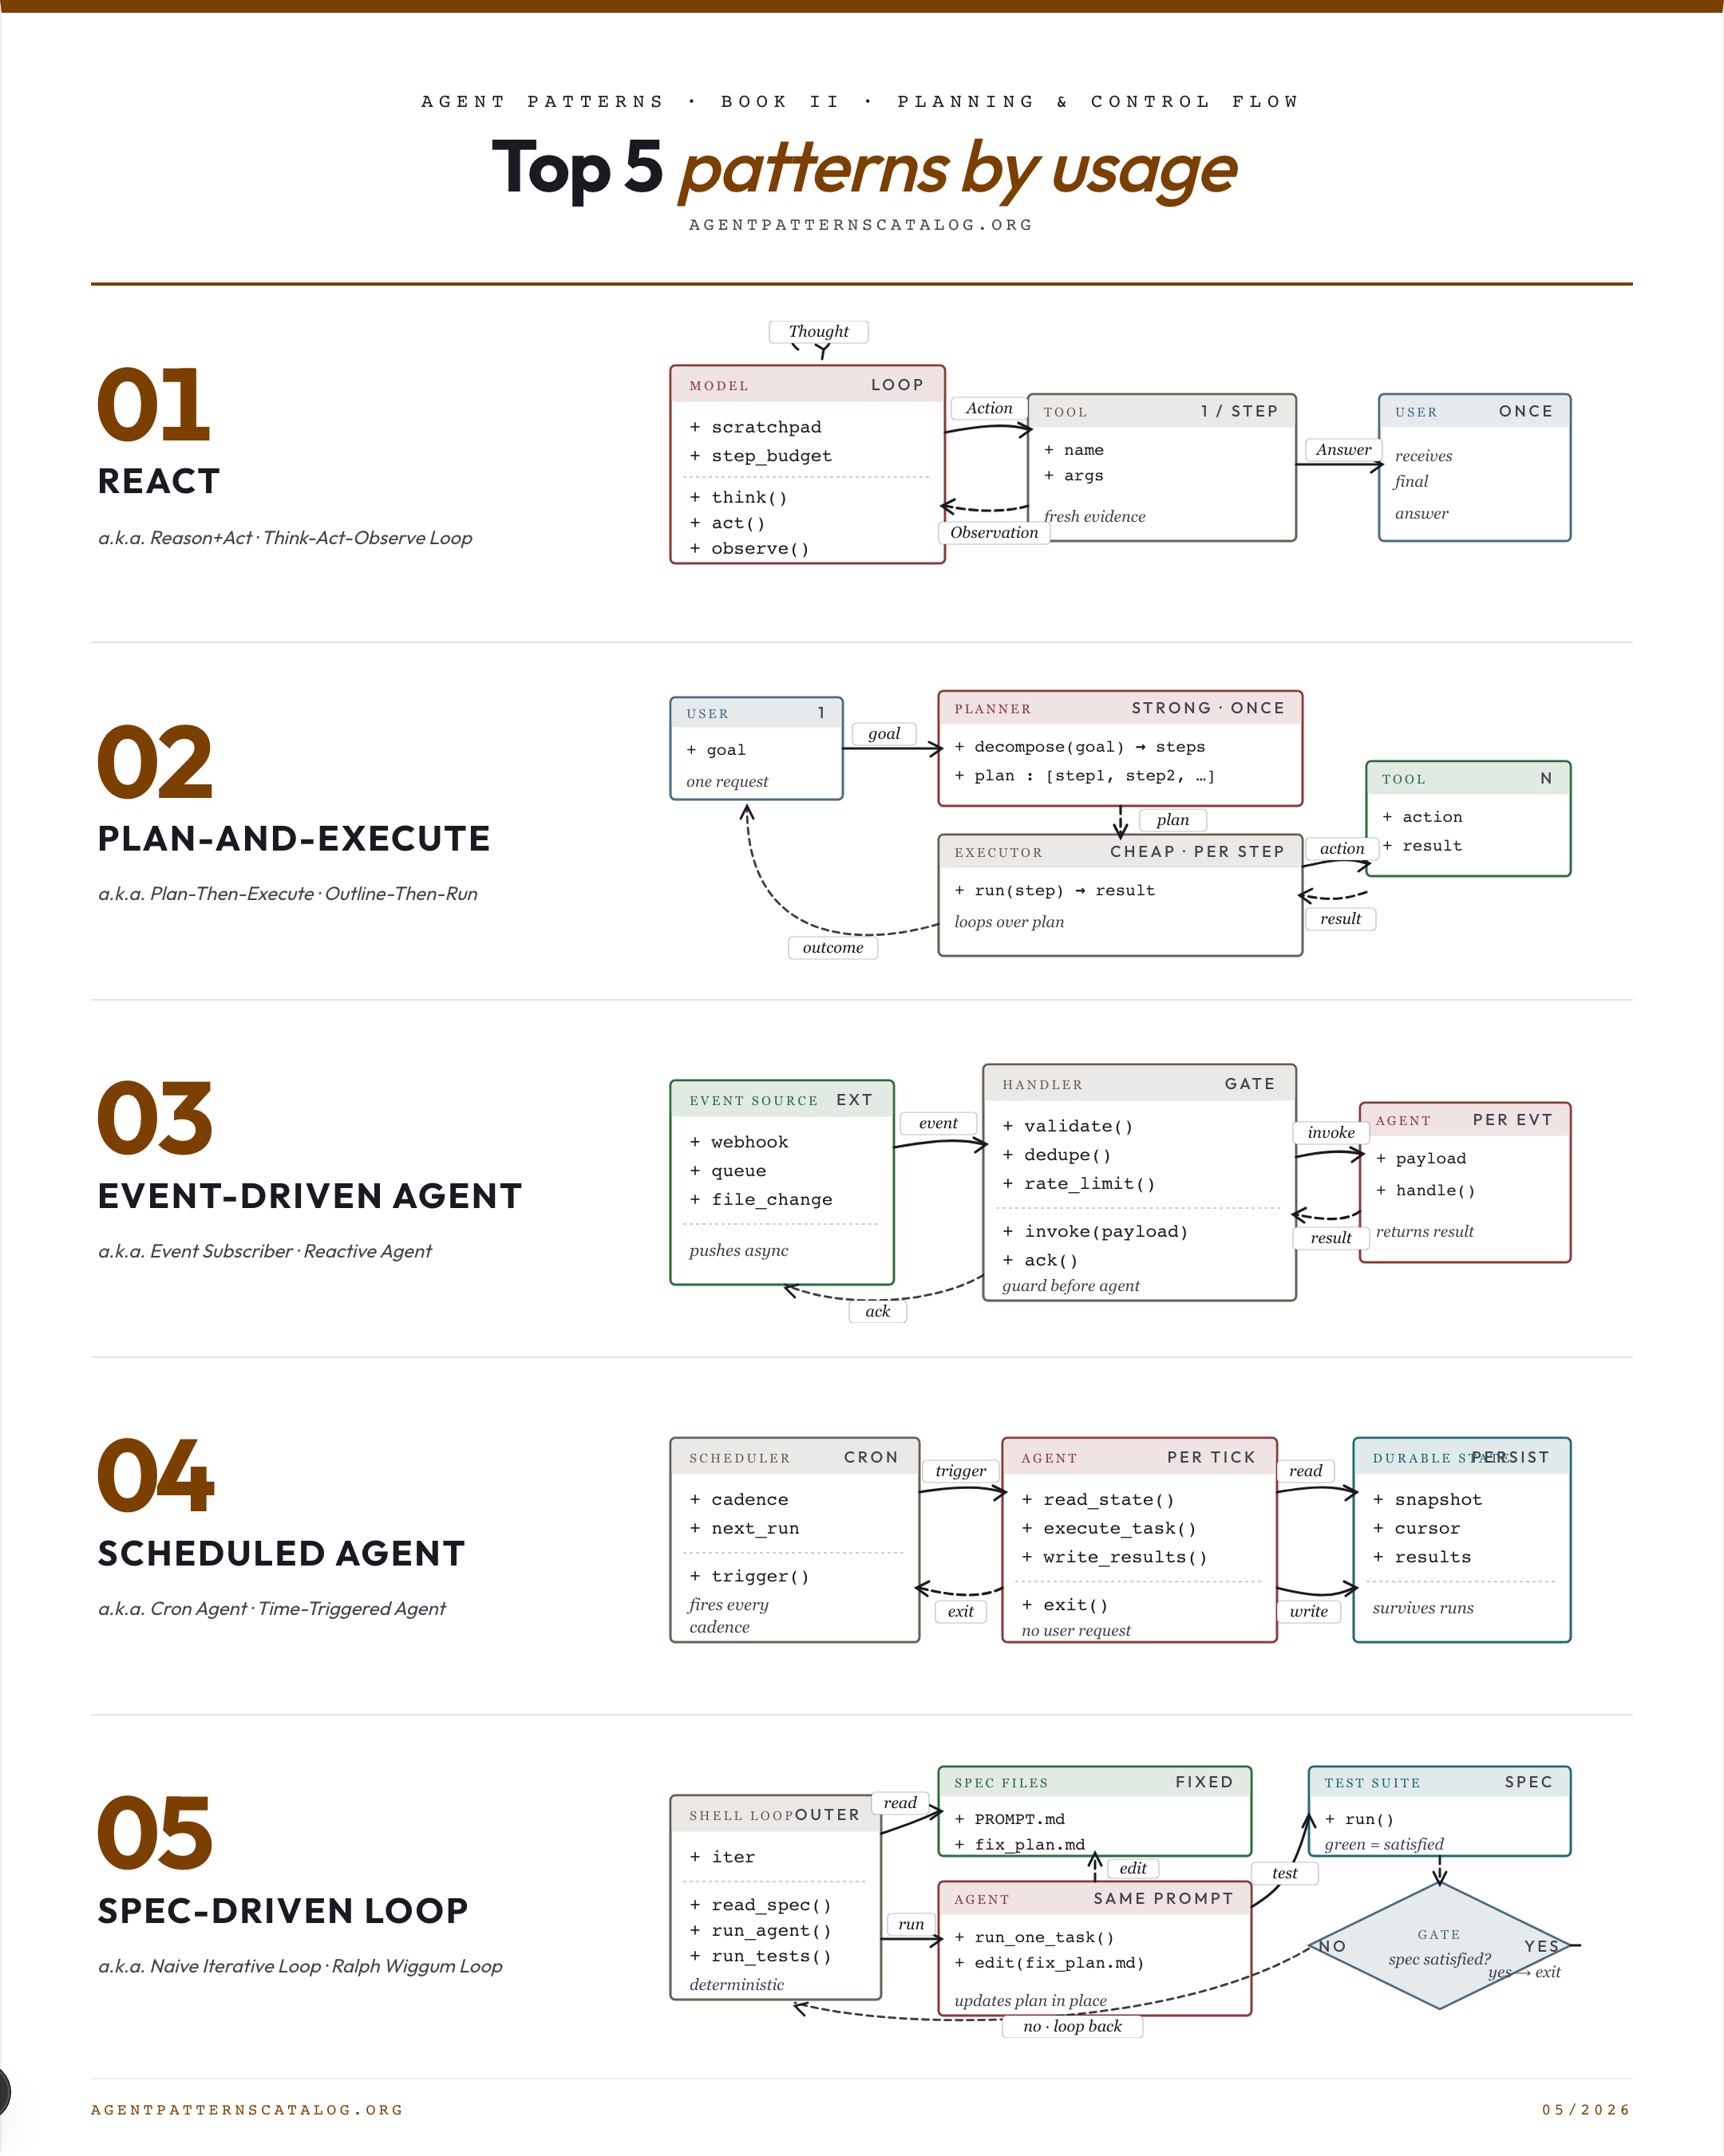
何时使用每种模式
01. ReAct 在每一步中交替进行一个思考、一次工具调用和一次观察,以便代理能够基于新证据进行推理。 最佳适用: 下一步行动取决于从上一步行动中学到的内容。 权衡: 本质上是顺序的;长路径是缓慢且昂贵的。 注意事项: 完整计划在开始时已知;Plan-and-Execute 早期承诺。
02. Plan-and-Execute 一次性使用强大的模型规划所有步骤,然后在计划下使用更便宜的模型执行每个步骤。 最佳适用: 任务可以干净地分解为大多数独立的步骤。 权衡: 当世界与规划者的心理模型不同时,计划可能会变得脆弱。 注意事项: 每一步的结果实质性地改变了下一步应该是什么——ReAct 适用。
03. Event-Driven Agent 在外部事件(webhooks、消息队列、文件更改)上触发代理,而不是用户请求或计划任务。 最佳适用: 存在外部事件源(webhook、队列、文件监视器),按计划拉取会浪费精力。 权衡: 事件源故障会静默地停止代理。 注意事项: 不存在事件源,轮询是唯一可用的触发器。
04. Scheduled Agent 在固定的时间表上运行代理,与用户请求无关。 最佳适用: 任务应定期运行,无论用户是否提示。 权衡: 每次运行的成本与需求无关。 注意事项: 任务仅在响应特定用户请求时才重要。
05. Spec-Driven Loop 在确定性的外部循环中对固定规范运行相同的提示,直到满足该规范。 最佳适用: 任务有明确(或可改进)的规范,增量迭代能带来价值。 权衡: 容易在错误的形状上浪费令牌。 注意事项: 任务没有规范,无法进行增量改进。
本书中的所有模式
ReAct
×60在每一步中交替进行一个思考、一次工具调用和一次观察,以便代理能够基于新证据进行推理。
Plan-and-Execute
×37一次性使用强大的模型规划所有步骤,然后在计划下使用更便宜的模型执行每个步骤。
Event-Driven Agent
×21在外部事件(webhooks、消息队列、文件更改)上触发代理,而不是用户请求或计划任务。
Scheduled Agent
×16在固定的时间表上运行代理,与用户请求无关。
Spec-Driven Loop
×12在确定性的外部循环中对固定规范运行相同的提示,直到满足该规范。
Visual Workflow Graph
×10将代理逻辑以可视化图形的形式表达为在画布上连接的类型节点,包含开始和结束节点,以便非编码利益相关者可以阅读和编辑流程。
Todo-List-Driven Autonomous Agent
×10让代理在运行初期创建一个计划文件(例如 todo.md),在完成项目时勾选它们,并将剩余计划重新注入上下文;该文件是持久的计划和工作记忆。
Spec-First Agent
×6从人类编写的规范文档驱动代理循环,而不是自由形式的提示。
Replan on Failure
×3当执行证据与当前计划相矛盾时触发新的规划步骤。
Deterministic Control Flow, Not Prompt
×3分支决策存在于确定性的应用代码中,而在战略性点调用LLM以产生结构化信号,供代码进行分支。
Iteration Node
×2在可视化工作流中将对集合的映射表达为一个显式的迭代节点,该节点对输入数组的每个元素运行一次子图,具有有限、确定性和可观察的执行。
Local-to-Cloud Handoff
×2在任务中将交互式本地代理会话提升为一个独立的云代理,该代理在开发者断开连接后继续运行并异步报告。
MapReduce for Agents
×2将一个过大的任务拆分为独立的块,分别并行处理,然后汇总。
Pre-Flight Spec Authoring
×2在生成任何代码之前,编写一个多支柱规范,并让代理对其模糊性和边缘情况进行批评,以便循环针对经过审查的目标执行,而不是新的提示。
Stateless Reducer Agent
×2将代理设计为一个纯函数 (state, event) → newState;整个执行历史保存在外部事件日志中;支持暂停/恢复/重放/时间旅行,而无需定制检查点。
Agentic Behavior Tree
×2借用行为树形式:叶子是返回成功/失败的LLM调用或工具;选择器和序列的树形结构协调控制流。
Language Agent Tree Search
×2将代理循环提升为具有学习值函数和回溯的搜索树。
LLMCompiler
×2获取 ReWOO 的计划作为 DAG,并通过任务获取调度器并行运行独立步骤。
ReWOO
×2在任何工具运行之前,规划一个完整的依赖DAG,并使用占位符变量,然后执行并将观察结果替换到计划中。
Disambiguation
×1让代理在对模糊请求采取行动之前询问澄清问题。
Goal Decomposition
×1递归地将一个目标分解为子目标,直到每个叶子都是直接可操作的。
Incremental Model Querying
×1通过在每一步依次查询模型来生成计划步骤,而不是一次性在一个调用中生成整个计划。
Query-Decomposition Agent
×1一个明确的代理,其工作是将传入的用户查询拆分为更小的独立子查询,这些子查询可以顺序或并行回答,然后合并结果。
Single-Path Plan Generator
×1从当前状态到目标生成一个线性中间步骤序列——轻量级规划的替代方案,适用于树状思维和多路径生成。
Planner-Executor-Observer
×1在 Planner 和 Executor 之间添加一个明确的 Observer 角色,以便根据计划检查进度,而不是盲目信任。
Proactive Goal Creator
×1通过捕捉周围的多模态上下文(手势、屏幕状态、环境)来预测用户的目标,除了用户输入的文本或语音。
Rumination Agent
×1通过一个漫长的思考-搜索-验证-修订-行动循环,运行一个单一代理,跨越数百个工具调用,自主地重新构建假设。
Standing State Injection
×1在每个回合重新计算一个紧凑的任务状态快照,并在模型推理之前将其作为新的系统块注入,以便长时间的工具调用循环始终保持目标导向。
Tool-Result Reinforcement
×1在每个工具返回中附加一个目标提醒、当前任务状态以及失败或下一步提示,以便代理通过它已经读取的动作通道重新定位。
Behavior Tree Back Chaining
×1从期望的目标条件开始构建代理的行为树,并递归地添加满足每个父节点前置条件的子节点。
Clone Fan-Out Research
×1并行生成100个或更多相同的、具备完整能力的代理实例——每个都是一个完整的通用代理,而不是角色专门化的工作者——并将它们的独立输出汇总为一个单一答案。
Distributed Constraint Optimization
×1一组代理共同为共享变量分配值,以最小化(或最大化)由代理间约束定义的全局成本,仅交换所需的消息。
Outer-Inner Agent Loop
×1运行两个嵌套循环:外部规划代理将目标分解为子任务;内部执行者在每个子任务上运行 ReAct 循环,外部代理可以根据内部的进展重新规划。
Partial Global Planning
×1每个代理维护其他代理计划的部分视图,并将本地计划逐步合并为共享的部分全球计划,同时交替进行协调和执行。
Planner-Generator-Evaluator Harness
×1将一个长期运行的任务分解为三个角色隔离的代理——一个发出特征列表的规划者,一个在每个新上下文中处理一个块的生成器,以及一个根据评分标准进行评估而不查看生成器痕迹的评估者。
Multi-Path Plan Generator
在每个计划节点生成多个候选下一步,以便后续选择——规划生成器模式与树思维 / LATS 风格搜索相结合。
Decision Context Maps
在任何重要决策之前,要求代理收集一组声明的上下文输入(资源可用性、时间表、下游依赖关系)到一个“上下文图”中,决策必须引用该图。
Exploration vs Exploitation
在采取最佳已知行动(利用)与尝试可能更好的替代方案(探索)之间取得平衡。
Hybrid HTN + Generative Agent
层次任务网络分解提供了程序性基础;生成的 LLM 仅在叶节点被调用,用于任务中真正开放式的部分。
Passive Goal Creator
分析用户表达的提示和相关上下文,以在任何规划或工具使用开始之前得出一个精确、可操作的目标。
Strategic Preparation Phase
在代理尝试解决方案之前,强制进行明确的问题空间表示步骤,反映专家人类在解决问题之前如何构建约束和依赖关系的心理模型。
Adaptive Branching Tree Search
在推理时间搜索树的每个节点上,使用汤普森采样来决定是加深现有答案还是进行新的尝试,选项是每个节点选择调用哪个底层LLM。
Mental-Model-In-The-Loop Simulator
在真实世界中承诺之前,在环境的内部模拟器中运行候选的多步骤策略——比模拟-再执行(单个动作)更广泛,通过模拟多步骤策略。
Speculative Agentic Actions
预测代理最有可能在当前回合发出的工具调用,并在当前回合预先执行它们,然后保留确认轨迹所需的结果,丢弃其余结果。
Two-Rate Cloud-Brain / Edge-Controller Split
以低频率运行一个慢速规划器,发出一个紧凑的潜在计划,并使用一个小型的设备控制器在机器人的本地控制速率下跟踪它,而不会在规划器上阻塞。