推理Reasoning
模型在行动之前是如何思考的。
本书中有 20 种模式。 · 已更新
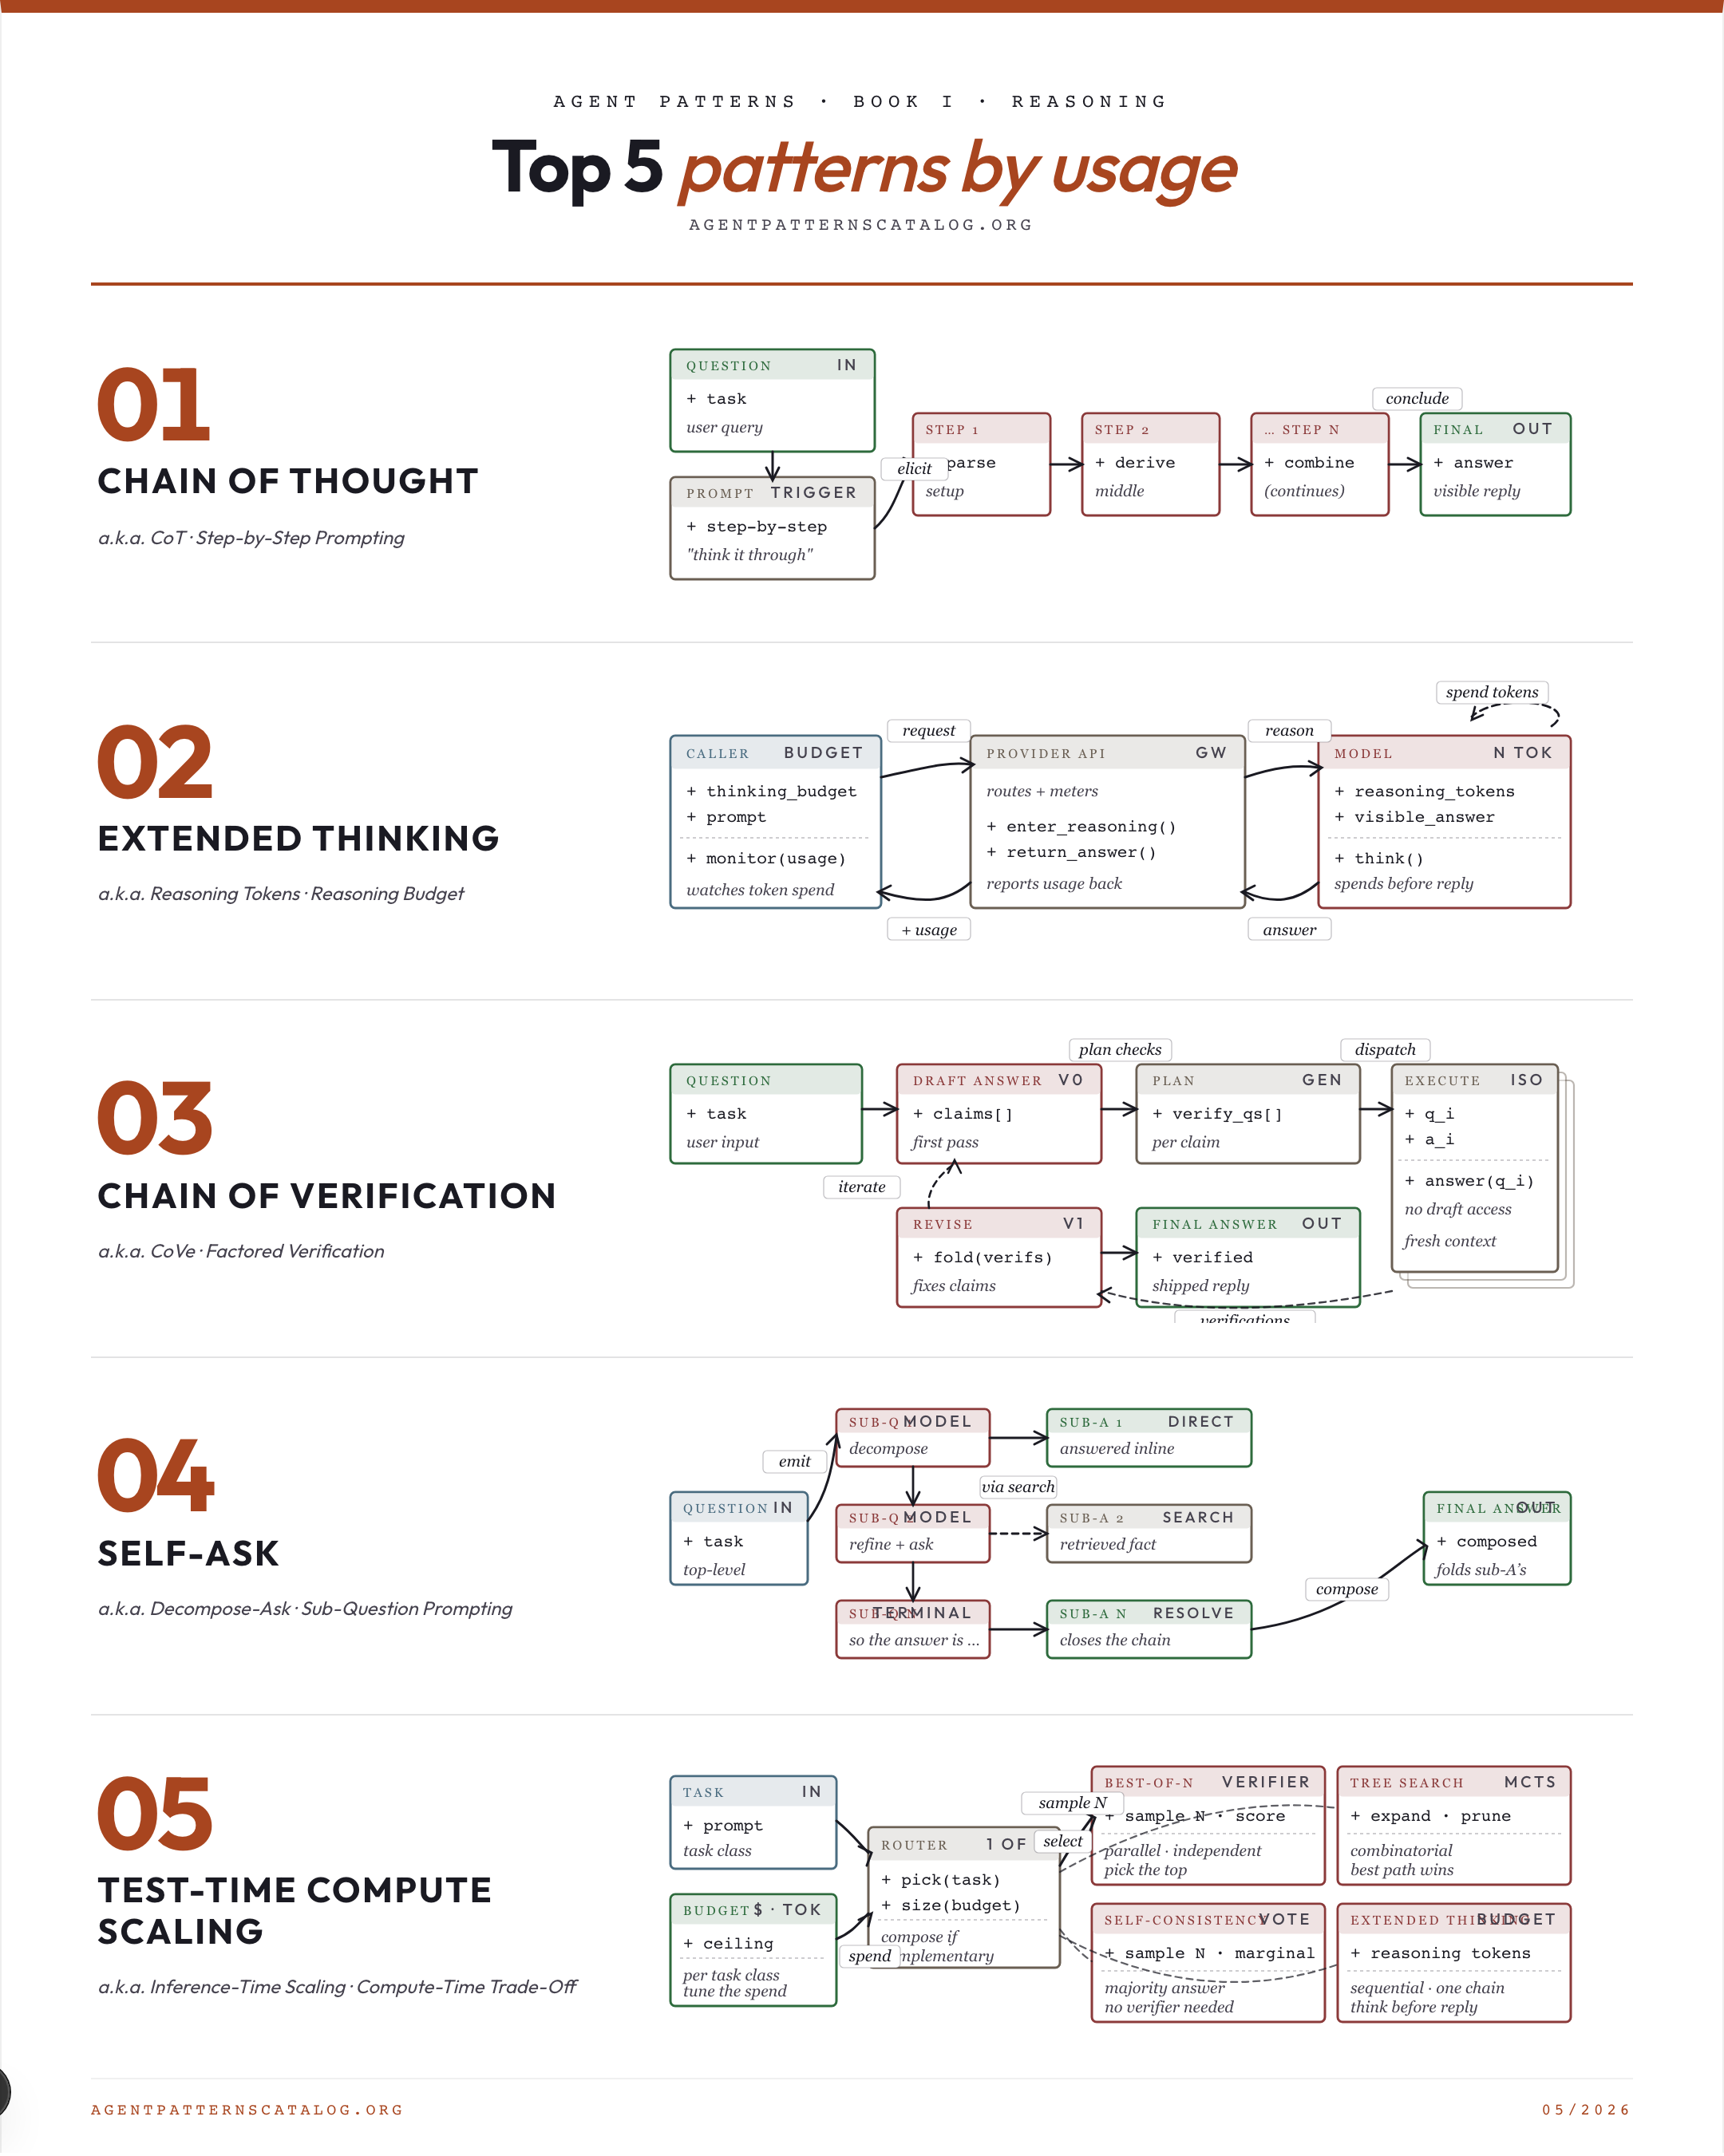
何时使用每种模式
01. Extended Thinking 在生成用户可见的答案之前,花费可配置的内部推理令牌预算。 最佳适用: 提供者暴露了推理预算 API,您想要调整每个请求的努力。 权衡: 预算成本激增。 注意事项: 基于静态提示的思维链已经满足质量和成本目标。
02. Chain of Thought 通过提示模型生成中间步骤来引导多步骤推理,最终得出答案。 最佳适用: 任务需要多步骤推理,而单次回答无法满足。 权衡: 单一线性追踪;没有分支或自我修正。 注意事项: 任务是直接查找或模式补全,推理步骤没有增加质量。
03. Chain of Verification 通过起草答案、生成独立的验证问题、单独回答这些问题并进行修订来减少幻觉。 最佳适用: 当模型在与草稿相同的上下文中自我验证时,会产生虚假声明。 权衡: 基线成本的4倍。 注意事项: 任务没有事实声明需要验证(纯粹的风格或生成任务)。
04. Large Reasoning Model (LRM) Paradigm 将推理密集型任务路由到一个经过推理调整的模型,该模型在深思熟虑上牺牲推理时间,而不是路由到一个表现出过早结束的快速 LLM。 最佳适用: 混合任务负载,包含简单和约束较重的查询。 权衡: LRM 的延迟对于某些面向用户的流程不可接受。 注意事项: 所有快速的用户交互流程。
05. Socratic Questioning Agent 通过向用户提出一系列战略性、开放式的问题,推动代理朝着其目标前进,这些问题能够揭示用户自身潜在的知识、目标或背景——而不是直接给出答案。 最佳适用: 辅导、教练和教育工作负载,其中用户理解是目标。 权衡: 对于只想要答案的用户来说,比直接回答更慢且更昂贵。 注意事项: 纯信息检索任务,用户只想要一个答案。
本书中的所有模式
Extended Thinking
×5在生成用户可见的答案之前,花费可配置的内部推理令牌预算。
Chain of Thought
×4通过提示模型生成中间步骤来引导多步骤推理,最终得出答案。
Chain of Verification
×3通过起草答案、生成独立的验证问题、单独回答这些问题并进行修订来减少幻觉。
Large Reasoning Model (LRM) Paradigm
×2将推理密集型任务路由到一个经过推理调整的模型,该模型在深思熟虑上牺牲推理时间,而不是路由到一个表现出过早结束的快速 LLM。
Socratic Questioning Agent
×2通过向用户提出一系列战略性、开放式的问题,推动代理朝着其目标前进,这些问题能够揭示用户自身潜在的知识、目标或背景——而不是直接给出答案。
Self-Ask
×1让模型发出明确的后续子问题,回答这些问题(可选地通过搜索),然后组成最终答案。
Test-Time Compute Scaling
×1分配更多推理时间计算(样本、搜索、更深入的思考),而不是扩展参数以提高质量。
Zero-Shot Chain-of-Thought
×1通过单个触发短语引发逐步推理,而不是少量示例。
Adaptive Compute Allocation
×1根据输入难度为每个查询分配推理时的计算(思考令牌、样本、深度、模型大小),而不是在所有查询中使用固定预算。
Attentive Reasoning Queries
×1用一个针对特定领域的结构化查询序列替换自由形式的思维链,以重新引导模型的注意力,关注在生成步骤中容易偏离的关键指令和先前决策。
Generate-and-Test Strategy
×1并行生成多个候选解决方案,然后系统地测试每个解决方案是否符合声明的约束,而不是急于承诺第一个看似合理的解决方案——改编自Langley和Simon关于人类专家问题解决的认知科学研究。
ReST-EM
×1迭代生成 → 奖励过滤 → 微调,以在没有人工标注数据的情况下启动推理能力。
STaR Bootstrapping
×1通过训练模型自身正确的思维链输出,来引导模型的推理。
Tree of Thoughts
×1在具有明确的前瞻、评估和回溯的部分推理状态树上进行搜索。
Learnability-Frontier Task Sampling
将训练回合预算花费在代理当前有时能解决的任务上,放弃每次尝试都能解决的任务和每次尝试都无法解决的任务,因为这两者都会产生零方差组且没有梯度。
Least-to-Most Prompting
将一个困难的问题分解为一个有序的较简单子问题列表,然后依次解决每个子问题,每个答案为下一个问题提供信息。
Graph of Thoughts
将推理建模为任意有向无环图,以便思想可以在分支之间合并、精炼和聚合。
Latent-Space Reasoning
让模型在连续的隐藏状态空间中推理,而不是将每一步解码为文本,将最后的隐藏状态反馈作为下一个输入嵌入,这样一个潜在步骤可以包含多个延续。
Recursive Language Model
将过长的提示视为模型通过代码导航的环境,让其对片段进行分区和递归调用,从而能够处理比其上下文窗口大得多的输入。
Trajectory-Summary Test-Time Scaling
当一个智能体的输出是扩展的动作-观察轨迹而不是简短的答案时,通过将每个回合压缩成结构化摘要并在这些摘要之间选择或重用,而不是使用原始轨迹,来缩放测试时间计算。