检索与RAGRetrieval & RAG
来自外部参数的知识。
本书中有 23 种模式。 · 已更新
何时使用每种模式
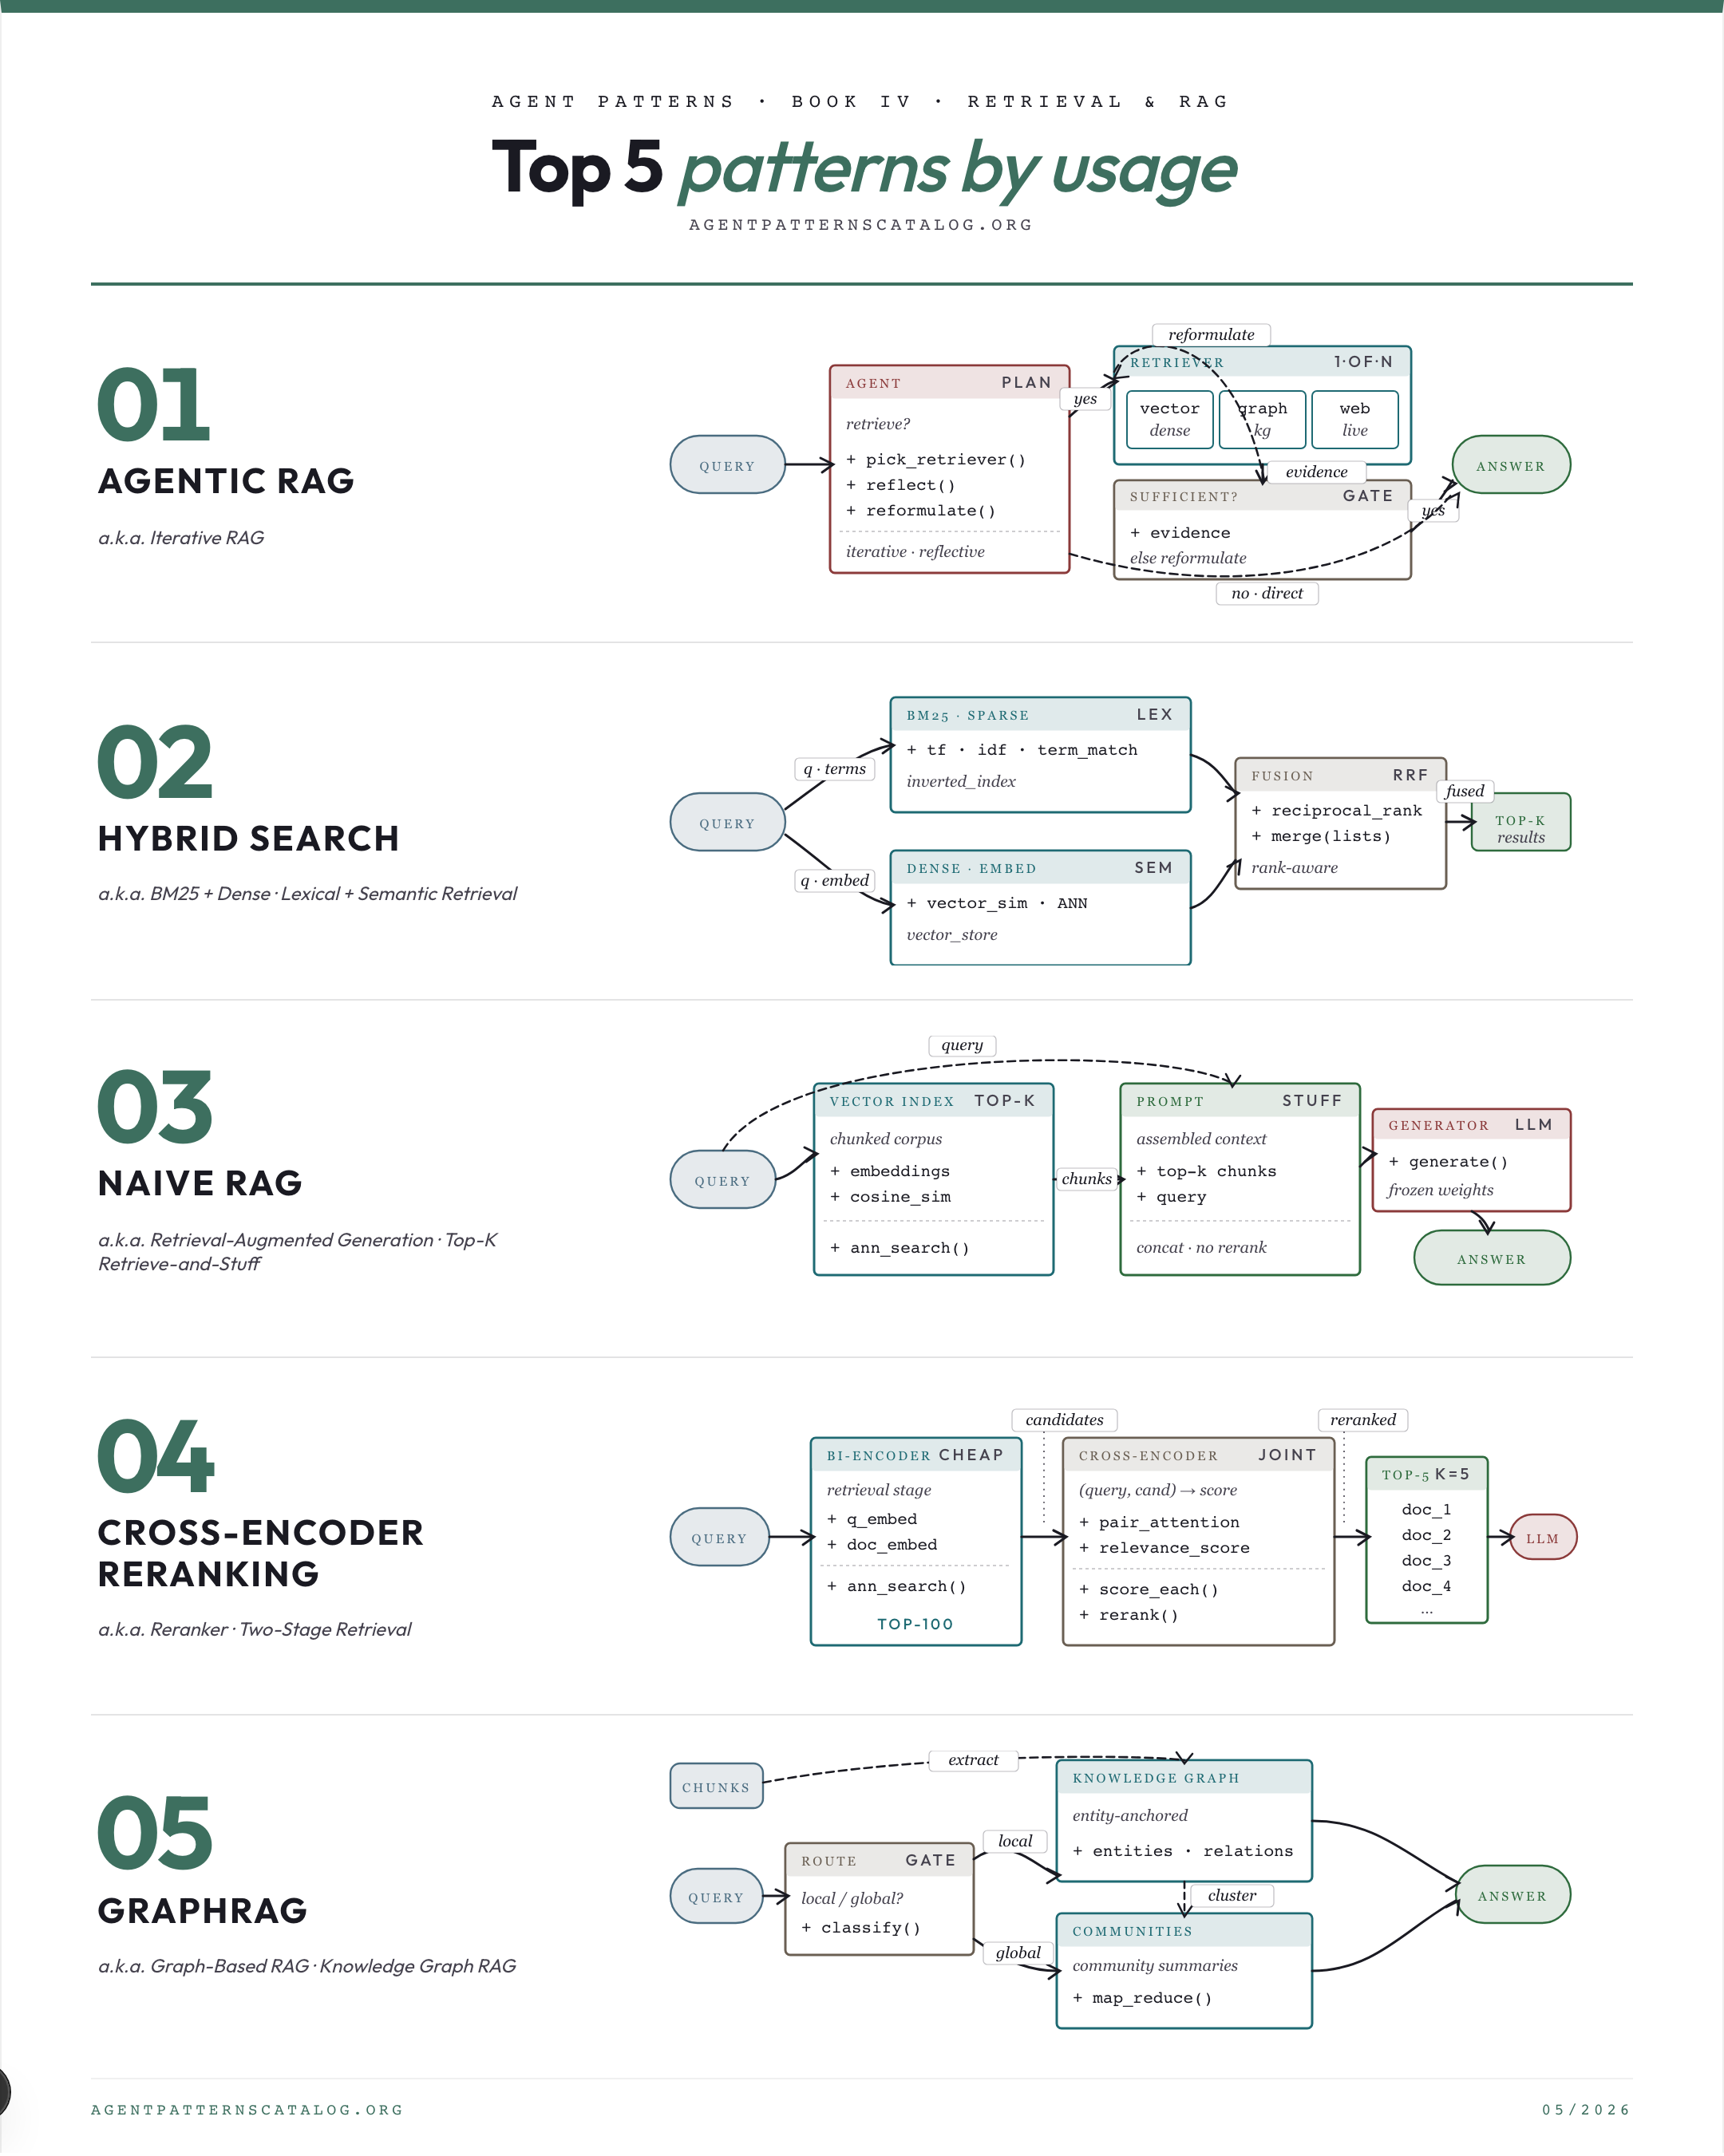
01. Agentic RAG 用自主代理替代静态的检索-生成,进行规划、选择来源、迭代检索、反思和重新查询。 最佳适用: 单次检索后生成的过程不足以满足任务的信息需求。 权衡: 随着循环迭代,成本和延迟上升。 注意事项: 静态一次性RAG已经以更低的成本和延迟达到了质量目标。
02. Hybrid Search 将稀疏的词汇检索(BM25)与密集向量检索相结合,并融合结果。 最佳适用: 查询将语义意图与稀有标记(代码、ID、专有名词)混合,这些标记的嵌入无法捕捉。 权衡: 需要保持两个索引同步。 注意事项: 语料库在概念上是统一的;单独的密集型就足够了。
03. Naive RAG 根据从外部密集索引检索到的前k个块来调整生成器,以便知识存在于参数之外。 最佳适用: 知识存在于模型之外,必须在查询时进行条件处理。 权衡: 块边界破坏上下文。 注意事项: 所需的知识已经在工具、数据库或特定系统提示中(见 naive-rag-first)。
04. Cross-Encoder Reranking 在廉价的双编码器或BM25检索之后,使用一个跨编码器对前N个候选项进行重新评分,该编码器共同关注(查询,候选项)。 最佳适用: 初始检索返回一个嘈杂的前100,并且前5的准确性很重要。 权衡: 延迟为每个候选者增加一个调用。 注意事项: 延迟目标是端到端小于100毫秒;交叉编码器会超出这个目标。
05. GraphRAG 构建一个LLM提取的实体和关系知识图谱,以及分层社区摘要,然后通过对这些摘要进行Map-Reduce来回答全局查询。 最佳适用: 用户提出全球性、语料库范围内的问题,而本地块检索无法回答。 权衡: 高索引成本(数量级更多的 LLM 调用)。 注意事项: 查询非常局部,而简单的RAG已经很好地满足了这些需求。
本书中的所有模式
Agentic RAG
×54用自主代理替代静态的检索-生成,进行规划、选择来源、迭代检索、反思和重新查询。
Hybrid Search
×11将稀疏的词汇检索(BM25)与密集向量检索相结合,并融合结果。
Naive RAG
×9根据从外部密集索引检索到的前k个块来调整生成器,以便知识存在于参数之外。
Cross-Encoder Reranking
×6在廉价的双编码器或BM25检索之后,使用一个跨编码器对前N个候选项进行重新评分,该编码器共同关注(查询,候选项)。
GraphRAG
×5构建一个LLM提取的实体和关系知识图谱,以及分层社区摘要,然后通过对这些摘要进行Map-Reduce来回答全局查询。
Citation Attribution
×4跟踪并展示与 RAG 相关的答案一起,哪些检索到的片段支持了哪些主张,以便答案片段与来源之间的绑定能够一直保持到用户。
Contextual Retrieval
×4在每个块嵌入之前,添加一个简短的LLM生成描述,以便该块携带其上下文。
Repo Map
×4给代理提供一个紧凑的、按排名排列的代码库符号及其依赖关系的地图,以便在阅读任何文件之前能够了解重要内容。
Query Rewriting
×3使用LLM生成用户查询的几种替代表述,为每种表述检索文档,并对结果进行排名融合,以便召回不依赖于单一表述。
HippoRAG
×3从语料库构建一个LLM提取的无模式知识图谱,并在查询的关键概念上运行个性化PageRank,以便多跳检索在一次传递中完成。
Semantic Response Cache
×3嵌入每个查询,当其最近的缓存邻居在相似性阈值内时,返回存储的答案,而不是重新运行模型,以便以低成本回答近似重复的问题。
Streaming Feature Pipeline
×3将原始文档处理为RAG特征,作为连续流而非批处理作业,使用类型化模型固定每个阶段。
CDC-Driven Vector Sync
×2将真实来源文档存储视为唯一的写入者;通过将变更数据捕获事件发送到特征管道消费的队列来保持向量索引的同步。
CRAG
×2添加一个轻量级的检索评估器,对每个检索到的文档进行评分,并在检索效果不佳时触发纠正的网络搜索。
HyDE
×2让LLM撰写一个假设的答案文档,嵌入它,并将其用作检索查询。
Modular RAG
×2将 RAG 分解为一个类型化的三层层次结构,包括模块类型、模块和操作符,以便根据查询重新排列管道(路由、调度、融合、检索、后检索、生成),而不是运行固定的线性检索-再生成流程。
RAFT
×2训练模型忽略领域特定RAG设置中的无关检索文档(干扰项)。
Hierarchical Retrieval
×1通过多级级联路由查询——粗略的源或索引选择,然后是每个源的更窄检索,最后是块级别——以便将每个检索决策推送到能够回答它的最便宜层级。
Self-RAG
×1微调模型以发出反思标记,决定何时检索、评估检索的相关性,并评估生成的支持。
Table-Augmented Generation
×1在三个阶段内回答关于数据库的自然语言问题——合成一个可执行的查询,使用嵌入执行的模型调用在数据层上运行它,然后从结果中生成答案。
Vectorless Reasoning-Based Retrieval
×1通过让模型沿着文档自身的目录树推理到相关部分进行检索,而不是嵌入块并通过向量相似性对其进行排名。
Tacit-Knowledge Elicitation Agent
运行一个前置阶段,在该阶段中,代理采访领域专家并将他们未记录的经验知识转化为一个结构化的、可查询的知识库,以便下游任务代理可以从中读取。
Dependency-Aware Skill Retrieval
从一个大型技能库中检索,通过返回每个相关技能及其先决依赖闭包作为有序子图,使得代理接收到的包是可执行的,而不是主题相关但不完整的。