结构与数据Structure & Data
输入、输出和工件的形状。
本书中有 10 种模式。 · 已更新
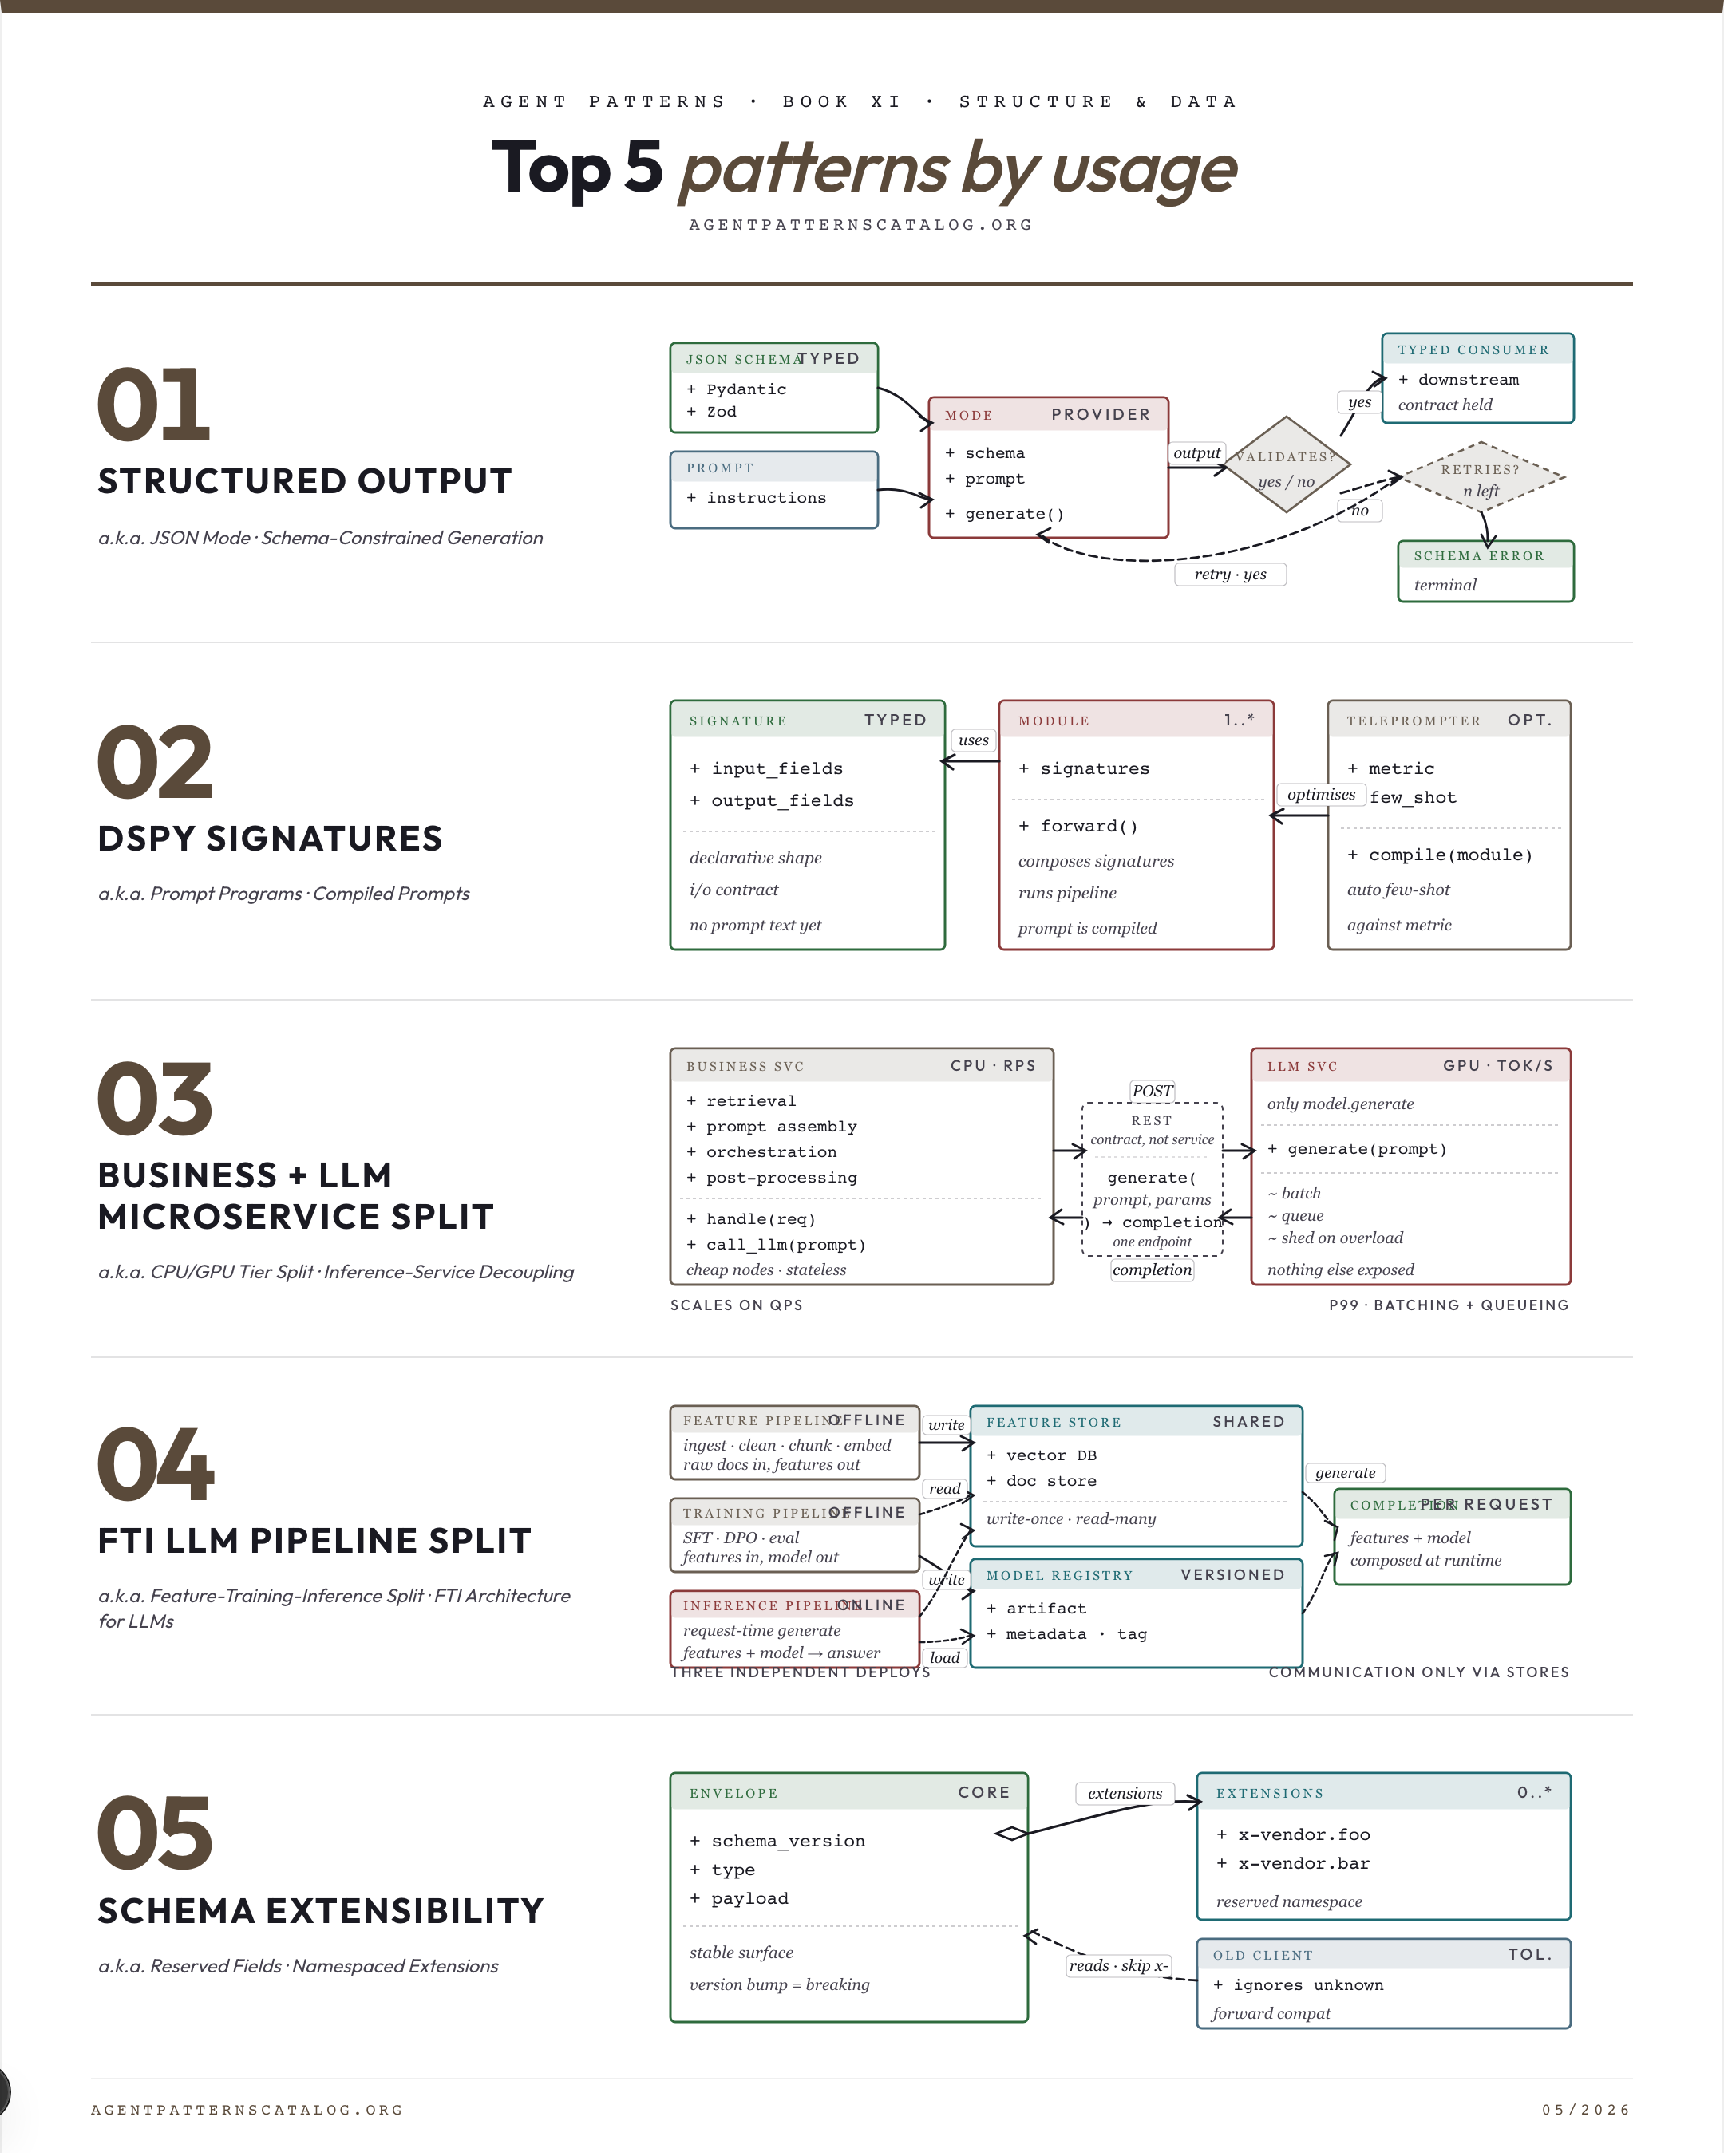
何时使用每种模式
01. Structured Output 限制模型的输出符合 JSON Schema(或类似的类型结构)。 最佳适用: 下游代码消费类型化数据,自由格式文本会破坏解析器。 权衡: 提供者锁定于最严格的模式。 注意事项: 输出仅供人类消费,结构没有增加价值。
02. Channel-Decoupled Agent Core 将代理的推理、工具和会话状态放在与通道无关的端口后面,并使每个交付表面(网页、语音、电子邮件、Slack、后台作业)成为适配器,以便一个核心服务于每个通道。 最佳适用: 同一个代理必须在多个交付表面(网页、语音、电子邮件、聊天应用)或在实时和无人值守模式下运行。 权衡: 标准化合同是设计瓶颈:它无法表达的渠道特性(流式令牌、丰富附件、语音中断)很难在不泄露渠道细节到核心的情况下呈现。 注意事项: 代理仅服务于一个频道,并且没有可预见的第二个表面,因此适配层纯粹是额外负担。
03. DSPy Signatures 将代理行为指定为声明性类型签名和模块;自动根据指标编译提示和少量示例。 最佳适用: 手工制作的提示是脆弱的,并且在模型版本之间漂移。 权衡: 编译需要标记或可自动评估的数据。 注意事项: 管道是单个提示,而DSPy机制则显得过于复杂。
04. Business + LLM Microservice Split 将 LLM 应用拆分为一个 CPU 绑定的业务微服务(检索、提示组装、协调)和一个 GPU 绑定的 LLM 微服务(仅在 REST 后面调用 model.generate),以便每个层级可以根据其自身的硬件预算进行扩展。 最佳适用: 当 LLM 推理和业务逻辑的扩展配置不同时。 权衡: 每次 LLM 调用增加一个额外的网络跳跃 — 延迟成本。 注意事项: 流量非常低——一个服务更简单且在预算内。
05. FTI LLM Pipeline Split 将LLM/RAG系统分解为三个独立可部署的管道——特征、训练、推理——仅通过特征存储和模型注册表进行通信。 最佳适用: 特征、训练和推理在节奏和所有权上有实质性差异。 权衡: 需要操作和版本控制的两个集成接口。 注意事项: 系统足够小,一个代码库和一个部署周期就可以了。
本书中的所有模式
Structured Output
×52限制模型的输出符合 JSON Schema(或类似的类型结构)。
Channel-Decoupled Agent Core
×3将代理的推理、工具和会话状态放在与通道无关的端口后面,并使每个交付表面(网页、语音、电子邮件、Slack、后台作业)成为适配器,以便一个核心服务于每个通道。
DSPy Signatures
×3将代理行为指定为声明性类型签名和模块;自动根据指标编译提示和少量示例。
Business + LLM Microservice Split
×1将 LLM 应用拆分为一个 CPU 绑定的业务微服务(检索、提示组装、协调)和一个 GPU 绑定的 LLM 微服务(仅在 REST 后面调用 model.generate),以便每个层级可以根据其自身的硬件预算进行扩展。
FTI LLM Pipeline Split
×1将LLM/RAG系统分解为三个独立可部署的管道——特征、训练、推理——仅通过特征存储和模型注册表进行通信。
Polymorphic Record
×1在单一核心模式中表示一组相关实体,并具有特定类型的扩展。
Prompt/Response Optimiser
×1在运行时,将用户输入和模型输出转换为标准化、与模板对齐的提示和响应,以符合预定义的约束,使代理及其下游消费者看到一致的形状。
Schema Extensibility
×1构建能够演变而不破坏旧客户端的模式,通过保留命名空间和扩展块。
Code-Switching-Aware Agent
×1将混合语言输入(例如罗马字母的Hinglish)视为预期形式,并设计标记化、语言标记和工具路由以原生方式处理,而不强迫用户选择一种语言。
LLM as Periphery
反转典型的中间LLM架构:一个确定性的状态机和事件存储构成核心;LLM仅限于边缘任务——输入解释和输出合成。