验证与反思Verification & Reflection
捕捉模型的错误。
本书中有 32 种模式。 · 已更新
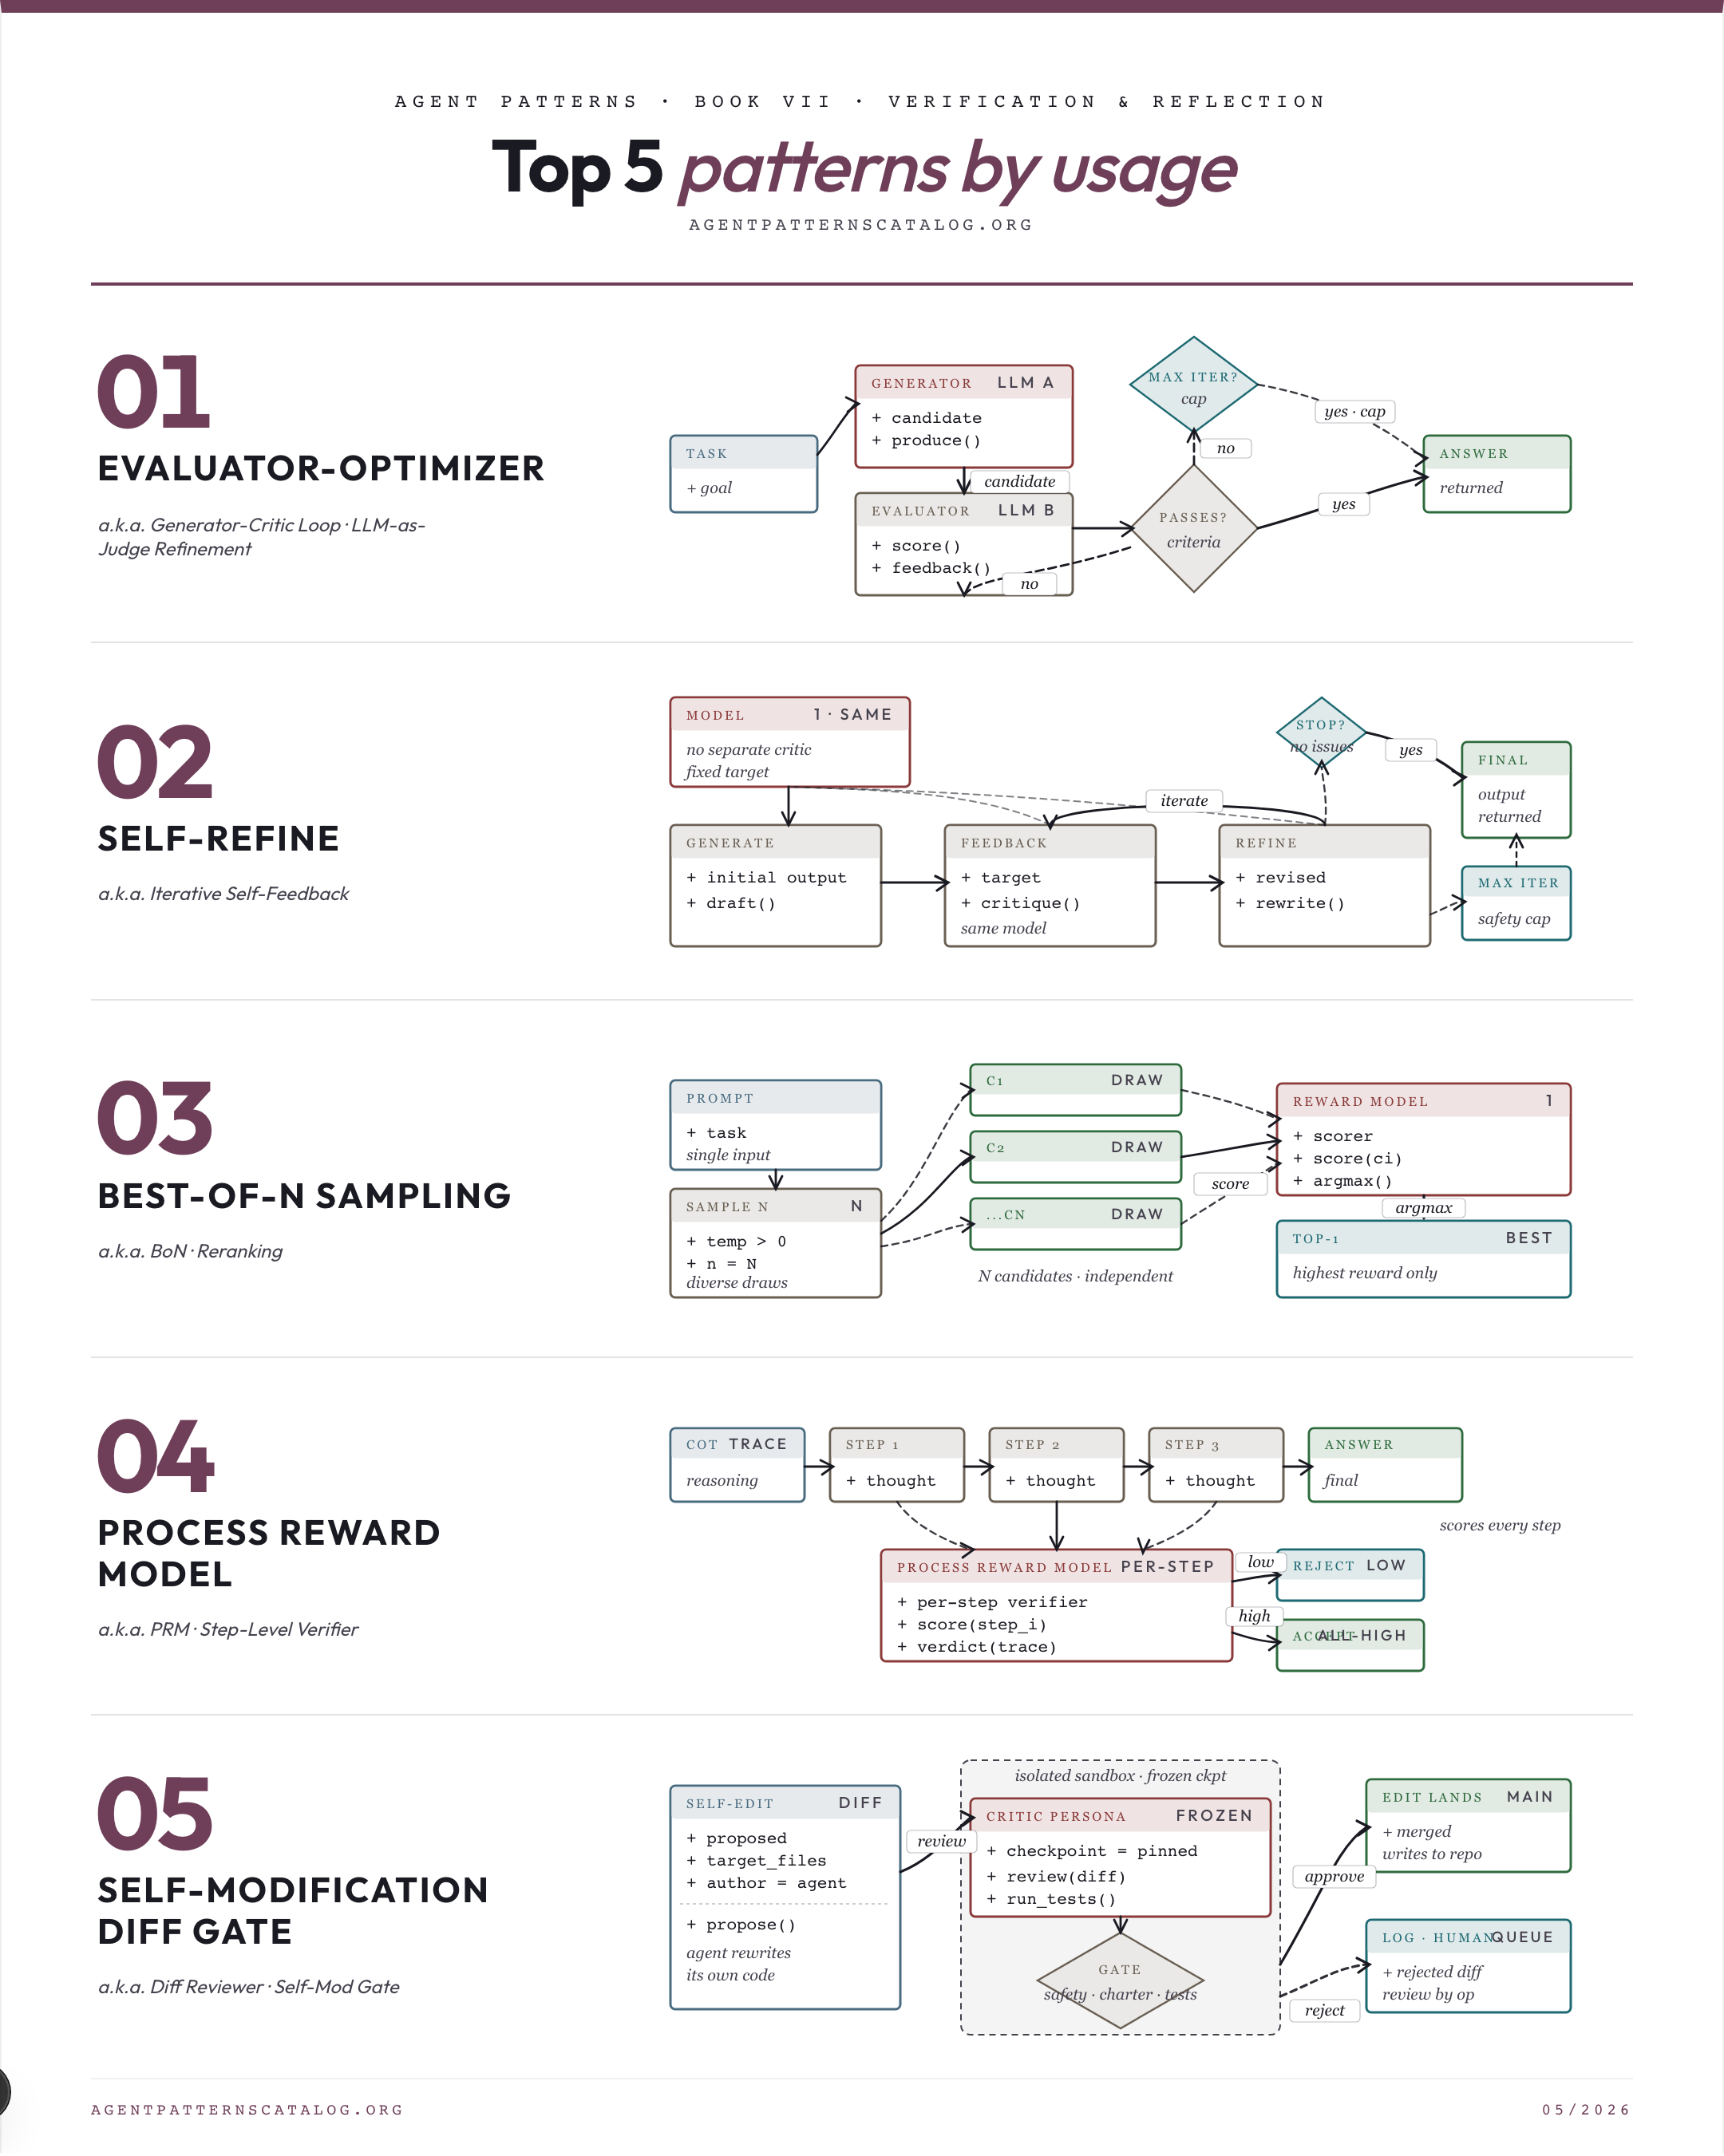
何时使用每种模式
01. Evaluator-Optimizer 一个LLM生成;另一个评估并反馈;循环直到满足标准。 最佳适用: 单次生成的质量低于任务所需的标准。 权衡: 成本 = (生成器 + 评估器) x 迭代次数。 注意事项: 单次生成已经满足质量目标。
02. Self-Refine 迭代生成 → 反馈(同一模型) → 精炼,直到触发停止标准,没有单独的批评模型。 最佳适用: 相同模型可以针对明确的改进目标产生有用的自我反馈。 权衡: 强化相同模型的盲点(Reflexion 复制研究)。 注意事项: 有不同的模型系列可用,并且可以提供独立的批评。
03. Best-of-N Sampling 对N个候选输出进行采样,并通过奖励模型或评分器选择排名最高的。 最佳适用: 存在一个评分器或奖励模型,可以比生成器选择的候选人更好地对候选人进行排名。 权衡: 成本与 N 成比例。 注意事项: 没有可靠的评分器可用于在候选人中进行选择。
04. Reflection 让模型审查自己的输出,并在一个或多个回合中生成修订版本。 最佳适用: 一次性生成未充分利用模型,批评过程可以捕捉错误。 权衡: 经过一两次处理后收益递减。 注意事项: 模型在一次处理时已经产生正确的输出。
05. Confidence Reporting 在答案本身旁边展示代理对其答案的不确定性。 最佳适用: 下游代码或用户界面需要在每个答案上区分 '我知道' 和 '我在猜测'。 权衡: 校准是经验性的,并且会漂移。 注意事项: 信心标签将被用户界面和路由层忽略。
本书中的所有模式
Evaluator-Optimizer
×6一个LLM生成;另一个评估并反馈;循环直到满足标准。
Self-Refine
×6迭代生成 → 反馈(同一模型) → 精炼,直到触发停止标准,没有单独的批评模型。
Best-of-N Sampling
×5对N个候选输出进行采样,并通过奖励模型或评分器选择排名最高的。
Reflection
×3让模型审查自己的输出,并在一个或多个回合中生成修订版本。
Confidence Reporting
×3在答案本身旁边展示代理对其答案的不确定性。
Process Reward Model
×3训练一个评分每个推理步骤的验证器,而不仅仅是最终答案。
Self-Modification Diff Gate
×3通过一个单独的评论者角色来审查差异,限制代理对其自身代码或规则的编辑。
Prompt Variant Evaluation
×2创建同一提示节点的多个变体,将它们作为批处理在共享数据集上运行,并让自动评估流程为它们打分,以便通过测量选择获胜的变体。
Dimensional Synthetic Eval Set
×2通过枚举显式命名的维度上的元组并从每个元组中引导生成,而不是通过自由形式的LLM提示(这会导致模式崩溃)来生成评估输入。
Frozen Rubric Reflection
×2将反思限制在一个固定的、手工编写的标准准则上,以便审阅者在每次运行时不能创造新的标准。
Tool-Augmented Self-Correction
×2通过与外部工具(搜索、代码执行、计算器)互动批评来自我修正LLM输出。
Reflexion
×2让代理从过去的失败中编写语言课程,并在未来的情境中参考它们。
Self-Consistency
×1在非零温度下多次采样相同的问题,并通过多数或判断进行聚合,以减轻幻觉现象。
Behavior-Pinning Test Before Agent Edit
×1在代理编辑之前捕获可触及代码的当前行为作为黄金特征测试,负载值以确定性计算,仅将文本留给模型,作为回归门。
Blind Grader with Isolated Context
×1在一个单独分配的上下文窗口中运行评估者,仅访问工件和评分标准,绝不接触生成代理的推理痕迹,以便评估者不会受到生产者框架的影响。
Checklist Partial-Credit Scoring
×1针对每个长期任务,根据特定任务的分级检查点进行评分,而不是仅仅使用一个通过/失败的二进制结果,这样即使进展和回归未改变二进制结果,仍然会在报告中显示出来。
Cross-Reflection
×1由与原始生成器不同的*其他*代理或基础模型执行的反思步骤,因此批评错误与生成错误解耦。
Deterministic-LLM Sandwich
×1在每个 LLM 调用的两侧都进行确定性检查。
Generator-Critic Separation
×1生成器代理负责生成草稿,批评者代理负责根据预定义标准对其进行评判,严格分离角色;批评者永远不生成。
Human Reflection
×1反思循环,明确收集人类反馈(而非批准),以改进代理计划,区别于仅让人类说是/否的批准门。
Red-Team Sandbox Reproduction
×1定期在每个版本的封闭沙盒中重新再现典型的对齐失败模式;将对齐回归套件视为部署门槛。
Stochastic-Deterministic Boundary (SDB)
×1将LLM提案与系统动作之间的缝隙形式化为一个四部分合同——提案者、验证者、提交步骤、拒绝信号——以便合同本身,而不是代理的良好意图,来控制副作用。
Verify-Before-Cite Resolution Gate
×1在生成后,将每个引用的权威与外部真实注册表进行核对,并在答案到达读者之前剔除或阻止任何不存在的引用。
Agentic Context Engineering Playbook
×1将代理的系统提示和长期记忆视为一个结构化的、可按项寻址的手册,通过Generator/Reflector/Curator循环的小增量更新不断演变,从而使积累的战术抵御单一重写所导致的上下文崩溃。
Commitment Tracking
×1从每个代理的轮次中提取声明的意图,形成一个结构化的账本,具有开放/已跟进/过期状态,使承诺与跟进之间的差距可见且可审计。
Darwin-Gödel Self-Rewrite
×1一个代理重写自己的源代码,归档每个成功的变体,并从归档中抽样变异父代,而不是最新版本,利用归档多样性作为跳出局部最优的跳板。
Echo Recognition
×1将人类消息的重复识别为强调或重新提问,而不是独立输入,以便代理在用户重复自己时不会产生近似重复的回复。
World Model as Tool
×1让规划代理调用生成世界模型作为工具,在承诺采取行动之前推出假设的未来,将世界模型视为可调用的模拟器,而不是训练目标。
Confidence-Checking Workflow
始终要求代理在其输出的每个部分中陈述其信心,并识别哪些部分需要人工验证,就像对初级分析师的工作进行分类一样。
Modality-Conflict Arbitration
让每个观察通道发出自己的记录声明,将通道之间的分歧视为检测到的事件,并根据预先声明的每种声明类型的模态权威来解决,而不是依赖隐式融合的猜测。
Physical-Evidence Progress Gate
仅在重新感知世界确认子目标确实发生后,推进具身代理的任务状态指针,而不是基于尝试执行该动作的事实。
Planner-Executor-Verifier (PEV)
三元专业化,其中规划者制定计划,执行者执行计划,独立的验证者检查每一步的效果是否符合原始目标。